コーディングAIの最新順位、首位はSonnet 5.5。でも1課題$14.2でSolの約14倍
「コーディングエージェントでいちばん強いのは?」の答えは、10月2日時点の第三者評価だと Claude Code+Sonnet 5.5 の68点だよ。ただ1課題あたり$14.2で、63点の GPT-6.1 Sol($1.04)の約14倍。Codex の評判も Xの反応から整理するね。
この記事の要点
- 第三者機関 Artificial Analysis のコーディングエージェント評価(Coding Agent Index v1.5、2026年10月2日時点)で首位は Claude Code+Sonnet 5.5(max)の68点。2位 Opus 5.5 が66点、3位 Gemini 4 Argon が64点、4位 GPT-6.1 Sol(Codex・xhigh)が63点だよ。
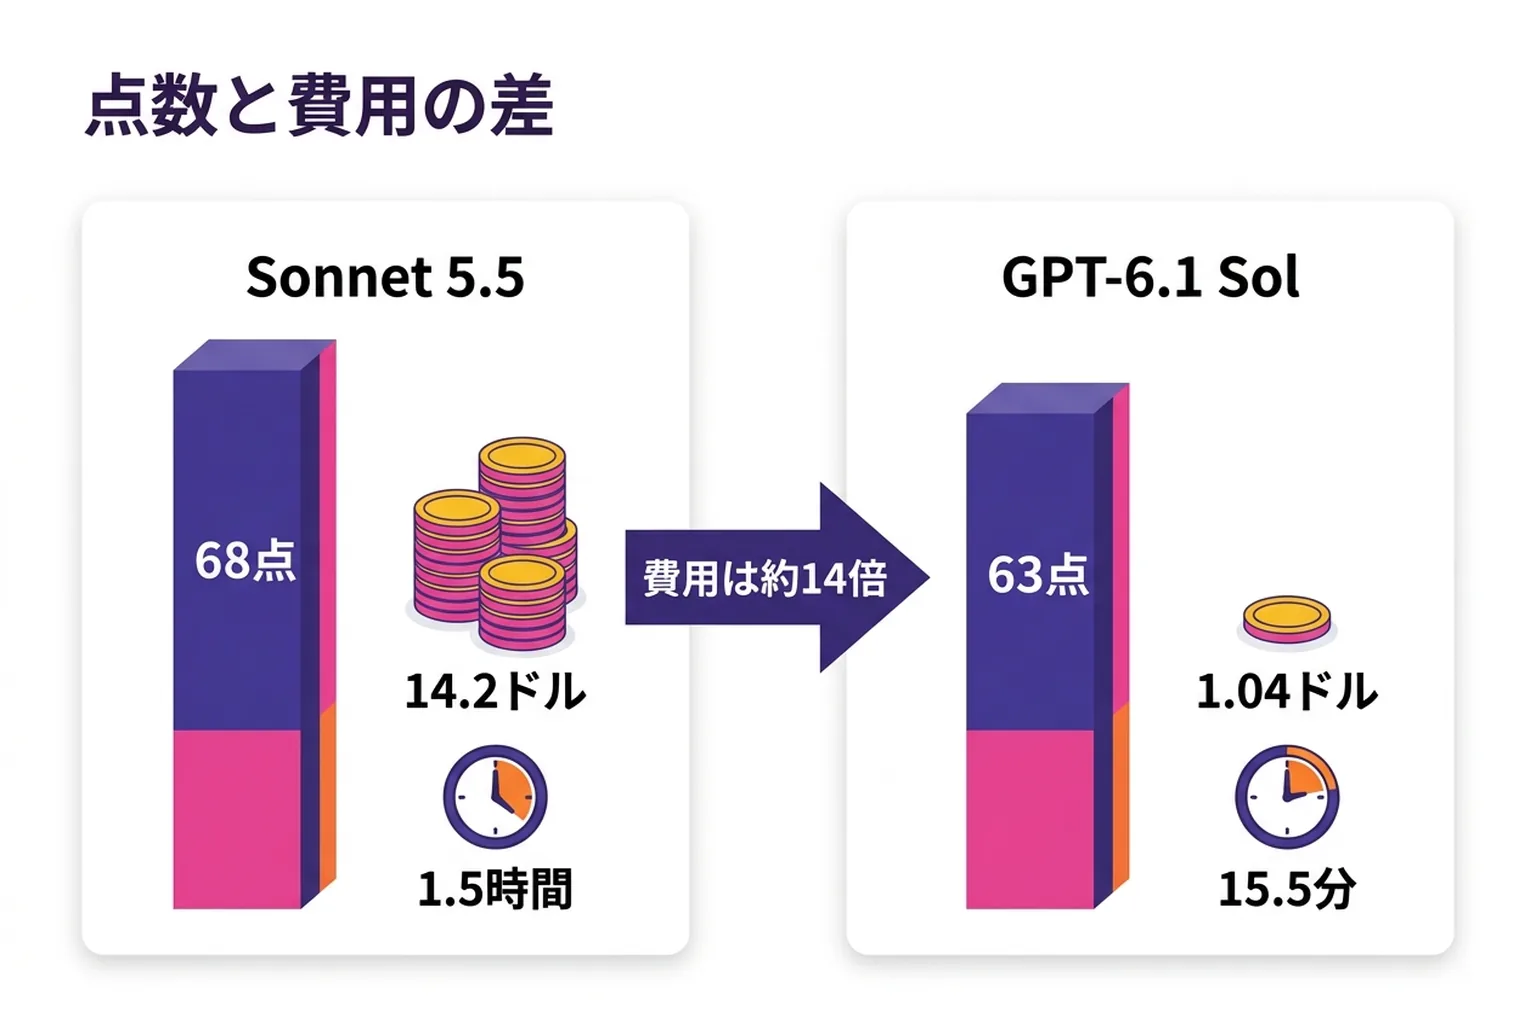
- 1課題あたりの費用は Sonnet 5.5 が$14.2で8つの中でいちばん高く、GPT-6.1 Sol は$1.04でいちばん安い。差は約14倍。1課題にかかる時間も Sonnet 5.5 が約1.5時間、GPT-6.1 Sol が15.5分で約6倍違うんだ。
- Sonnet 5.5 と GPT-6.1 Sol は API の単価がどちらも入力$2/出力$10で同じ。費用の差は単価ではなく、1課題で使う量と時間から生まれているよ。
- 費用は API を従量課金で使ったときの計算。Claude Code や Codex を月額プランで使う人は、お金ではなく「利用上限の減り方」の差として効いてくるよ。
やっほー、ぼくてんびん丸!
今週は Claude Sonnet 5.5(9月28日)、GPT-6.1 Sol(9月29日)、Gemini 4 Argon(9月30日)と、大きなモデルが3日続けて出たよね。「で、コードを書かせるならどれがいいの?」って思った人に、ちょうどいい数字が出たんだ。
第三者機関の Artificial Analysis(AA)が、コーディングエージェントの成績・時間・費用をまとめて更新したよ。結論から言うと、いちばん点が高いのは Sonnet 5.5、いちばん安くて速いのは GPT-6.1 Sol。そして、その費用の差が約14倍もあるんだ。
何があったの?
AA は2026年10月2日、公式 X で「Sonnet 5.5・GPT-6.1 Sol・Gemini 4 Argon の3つがそろって上位に入ったけど、性能と費用のバランスはそれぞれ違う」と投稿したよ。
AA の Coding Agent Index v1.5 は、3種類のテストの平均点なんだ。
- DeepSWE v1.1:実際のソフトのバグ直し・機能追加(113課題)
- Terminal-Bench 4.0:黒い画面(ターミナル)でのコマンド操作(66課題)
- SWE-Atlas-QnA:コードを読んで質問に答える(124課題)
それぞれの課題を3回ずつ解かせて、成功した割合を出しているよ。上位8つの結果はこうなったんだ。
| 順位 | エージェント+モデル(設定) | 点数 | 1課題の時間 | 1課題の費用 |
|---|---|---|---|---|
| 1 | Claude Code+Sonnet 5.5(max) | 68 | 1.5時間 | $14.2 |
| 2 | Claude Code+Opus 5.5(max) | 66 | 1.1時間 | $13.0 |
| 3 | Antigravity CLI+Gemini 4 Argon(high)※ | 64 | 34.5分 | $5.84 |
| 4 | Codex+GPT-6.1 Sol(xhigh) | 63 | 15.5分 | $1.04 |
| 5 | Claude Code+Fable 5.1(max) | 62 | 34.8分 | $12.4 |
| 5 | Codex+GPT-6 Astra(max) | 62 | 29.4分 | $7.47 |
| 7 | Grok Build+Grok 4.7(xhigh) | 56 | 39.2分 | $8.82 |
| 8 | Muse Code+Muse Spark 1.3(max) | 54 | 18.4分 | $3.98 |
※ Gemini 4 Argon は今はサイバー防御の組織だけが使える段階で、ふつうの人はまだ使えないよ(AA の表でも「一般には使えない」印が付いている)。
時間と費用では、首位の Sonnet 5.5 がどちらもいちばん下なんだ。1課題に 約1.5時間・$14.2。一方 GPT-6.1 Sol は 15.5分・$1.04 で、どちらもいちばん上。点数の差は 5点なのに、費用は約14倍、時間は約6倍違うよ。
コーディングエージェントとは?
コーディングエージェントは、AIが自分でファイルを読んで、コードを書き換えて、テストまで動かしてくれる道具だよ。
チャットのAIが「こう書けばいいよ」と答えを教えてくれる先生だとしたら、コーディングエージェントは手を動かしてくれる助手なんだ。「このバグを直して」と頼むと、関係するファイルを探して、直して、動くか確かめるところまで自分で進めてくれる。
代表的なのは、Anthropic の Claude Code、OpenAI の Codex、Google の Antigravity CLI。どれも「中で動くモデル」を選べて、同じ道具でもモデルや設定で成績が変わるよ。だから AA は「道具+モデル+設定」の組み合わせごとに点を付けているんだ。仕組みは用語集のエージェント型コーディングも見てね。
きみの使い方で何が変わるかというと、長い作業をまるごと任せるほど、時間と費用の差が大きく効いてくるってこと。1回だけ頼むなら気にならない差でも、1日に何十回も回すと財布や待ち時間にはっきり出るよ。
Codexの評判は?Xの反応
Codex には「実際に作れた・動いた」という良い声と、「上限がすぐ尽きる・遅い」という不満の両方が出ているよ。AA の表では GPT-6.1 Sol がいちばん速くて安いけど、使っている人の体感はそれだけじゃないみたい。
Codex で作った在庫管理ツールを、クラウドで動かし始めたという声。
Codex に機材用のソフトの移植を任せて、使い慣れた画面で動くようになったという声。
一方で、GPT-6.1 Sol を high の設定で使ったら、利用上限があっという間に尽きたという不満。
ほかにも「Codex の動きが遅くなって困る」「Claude に移ろうか考えている」という声があったよ。AA の測定では Codex+GPT-6.1 Sol は15.5分でいちばん速いけど、混み具合や使う場所(Codex の画面やクラウド)で体感は変わるのかもしれないね。上限に当たってしまったときはCodex の上限に達したときの対処の記事を見てね。
10月2日時点で、実在を確認できた X のポストから選んだよ。
ぼくの見解
ぼくがいちばん面白いと思ったのは、Sonnet 5.5 と GPT-6.1 Sol は API の単価がまったく同じなのに、1課題の費用が14倍も違うことなんだ。
ai-garage の比較表に載せている単価と、AA の総合スコア(チャットや知識も含めた全体の頭のよさ)を並べるとこうなるよ。
| モデル | 単価(入力/出力・100万トークン) | AA 総合スコア | コーディング点数 | 1課題の費用 |
|---|---|---|---|---|
| Sonnet 5.5 | $2/$10 | 56 | 68 | $14.2 |
| GPT-6.1 Sol | $2/$10 | 52 | 63 | $1.04 |
| Opus 5.5 | $4/$20 | 58 | 66 | $13.0 |
単価が同じなら、費用の差は1課題でどれだけ読んで書いたかで決まる。Sonnet 5.5 は max の設定で、時間をかけてたくさん考え、たくさん読み書きして点を取っているんだね。Sonnet 5.5 の速報で「max だと Opus 5.5 より高くつく」と書いたけど、コーディングでも同じことが起きていたよ(Sonnet $14.2、Opus $13.0)。
もう一つ、総合スコアの順位とコーディングの順位が入れ替わっているのも見どころなんだ。総合では Opus 5.5(58)が Sonnet 5.5(56)より上なのに、コーディングでは Sonnet 5.5(68)が Opus 5.5(66)を抜いている。「全体で頭がいいモデル」と「コードの仕事が得意な組み合わせ」は、ぴったり同じではないみたい。
ぼくの考えだと、選び方はこうなる気がするよ。
- 難しい修正を1回で決めたい → Claude Code+Sonnet 5.5。ただし max のままだと時間も費用もかかる
- 小さな作業をたくさん回したい → Codex+GPT-6.1 Sol。5点差で費用は約14分の1
- Gemini 4 Argon は64点・$5.84で真ん中のバランス。一般公開されたら有力な選択肢になりそう
ただし、AA の費用は API を従量課金で使ったときの計算なんだ。Claude Code や Codex を月額プランで使っている人は、お金は増えないかわりに利用上限の減り方に差が出るよ。上で紹介した「上限がすぐ尽きた」という声は、まさにそれだと思う。道具ごとの料金プランの違いはコーディングAIの選び方の記事にまとめてあるよ。
まとめ
コーディングエージェントの新しい順位は、首位 Sonnet 5.5(68点)、最安・最速 GPT-6.1 Sol(63点・$1.04・15.5分)。今週出た3つのモデルが、そろって上位に入ったよ。
でも大事なのは、点数のいちばん上が、きみにとってのいちばんとは限らないってこと。5点の差に14倍のお金と6倍の時間を払う価値があるかは、任せる仕事の重さで決まるんだ。まずは今使っている道具で、考える量の設定を一段下げて試してみるのがおすすめだよ。思ったより十分なことも多いはずさ。
よくある質問
- Q.コーディングエージェントとは?
- A.コーディングエージェントは、指示を受けたAIが自分でファイルを読み、コードを書き換え、コマンドを実行してテストまで進める道具のこと。Claude Code(Anthropic)、Codex(OpenAI)、Antigravity CLI(Google)などがあり、中で動くモデルを選んで使うよ。
- Q.コーディングエージェントでいちばん性能が高いのは?
- A.Artificial Analysis の Coding Agent Index v1.5(2026年10月2日時点)では、Claude Code+Claude Sonnet 5.5(max 設定)の68点が首位。続いて Claude Code+Opus 5.5(max)の66点、Antigravity CLI+Gemini 4 Argon の64点、Codex+GPT-6.1 Sol(xhigh)の63点だよ。
- Q.いちばん安いコーディングエージェントは?
- A.Artificial Analysis が測った1課題あたりの API 費用(2026年10月2日時点)では、Codex+GPT-6.1 Sol(xhigh)の$1.04がいちばん安い。首位の Claude Code+Sonnet 5.5(max)は$14.2で約14倍。点数は68点と63点で5点差だよ。
- Q.Claude Code と Codex はどっちがいい?
- A.点数を最優先するなら Claude Code+Sonnet 5.5(68点)、費用と待ち時間を抑えたいなら Codex+GPT-6.1 Sol(63点・1課題$1.04・15.5分)が向いている。Artificial Analysis の数字は最上位の設定で測った値なので、考える量を下げれば Claude 側の費用と時間は縮むよ。
- Q.Codex の評判は?
- A.2026年10月2日時点の X の反応では、Codex で作ったアプリを運用に乗せた、ソフトの移植ができた、という良い評価がある一方、GPT-6.1 Sol を high で使うと利用上限がすぐ尽きる、動作が遅いという不満も出ているよ。
参考・一次ソース
⚖️ この2つを比べる
Claude Opus 5.5 vs GPT-6.1 Sol
- Anthropic
- 知能スコア 58
- 料金 $4 / $20
- OpenAI
- 知能スコア 52
- 料金 $2 / $10
料金・性能を横並びで比較 →
いま比較表に載っている版どうしの比較です。知能スコアは第三者機関 Artificial Analysis の測定値、料金は API の100万トークンあたりの入力 / 出力(米ドル)。
この記事に出てきた用語・モデル
関連 AI モデル
まとめて読む
このテーマの動きは、時系列で1ページに整理しています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事