Claude Opus 5.5 登場!Fable 5.1 並みで費用は Opus 5 の4割減
「Claude Opus 5.5 はいつ出た?」の答えは2026年9月22日(米国時間)だよ。料金は入力$4/出力$20で Opus 5 より20%安く、Anthropic は「既定の設定で典型的な作業なら、費用は Opus 5 より40%少ない」と説明。たいていの仕事で Fable 5.1 並みの力があるとして、公式ドキュメントの案内も「迷ったらまず Opus 5.5」に変わったんだ。
この記事の要点
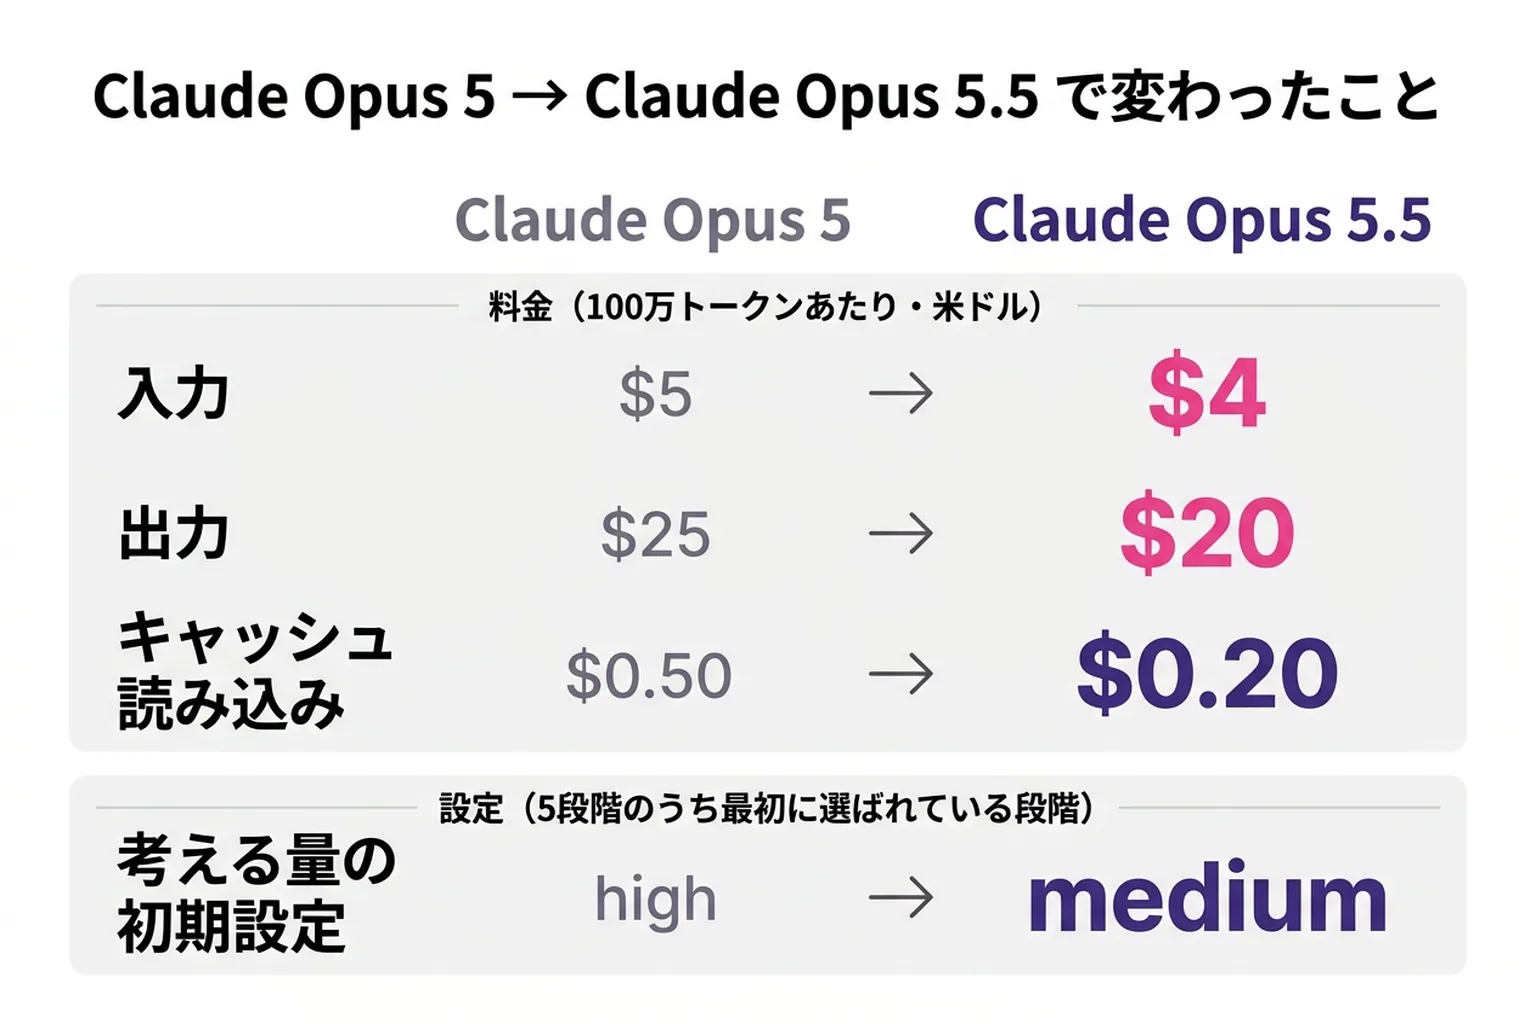
- 2026年9月22日(米国時間)、Anthropic が新しい Claude 5.5 ファミリーの最初のモデル Claude Opus 5.5 を公開した。料金は100万トークンあたり入力$4/出力$20で、前の Claude Opus 5($5/$25)より20%安い。キャッシュ読み込みは $0.50 から $0.20 に下がった。
- Anthropic は「既定の設定で典型的な作業なら、Opus 5 より費用が40%少ない」と説明している。単価の値下げに、1つの作業で使うトークンが減った分を合わせた数字で、考える量(effort)の既定値も high から medium に下がった。第三者の Artificial Analysis の測定では、いちばん考えさせる max 設定だと、指標のテスト全体での出力が2億6000万トークン(同じ価格帯のモデルの中央値は8800万)と多かった。
- システムカードの比較表では SWE-bench Pro 89.9%、Terminal-Bench 4.0 66.4%(xhigh 設定)などで Claude Fable 5.1 と Opus 5 を上回り、Artificial Analysis の総合指標も 58 で1位。一方、Terminal-Bench-Science 0.1(64.6% 対 58.7%)と AutomationBench(41.4% 対 40.0%)は OpenAI の GPT-6 Astra が上で、Anthropic 自身も「実際に使ったときの Fable 5.1 との差は点数ほど大きくない」と注記している。
- Claude のアプリでは Pro・Max・Team・Enterprise で使え、Pro・Max・Team・席ごとに払う Enterprise は5時間ごとの利用上限が引き上げられた(増える量は非公表)。Claude Code はバージョン 2.1.280 から Opus 5.5 が既定。Opus 5 は旧世代(Legacy)扱いになったが、提供終了は2027年7月24日より前にはならない。
やっほー、ぼくてんびん丸!
「いちばん賢いのは、値段もいちばん高い Fable」。そう覚えていた子は、今日からちょっと覚え直しだよ。2026年9月22日(米国時間。日本時間では23日の未明)、Anthropic が「Claude Opus 5.5」を公開したんだ。Anthropic によると、たいていの仕事で最上位の Fable 5.1 と同じくらいの力があって、動かす費用は前の Opus 5 より40%少ない。公式ドキュメントのおすすめも「迷ったらまず Opus 5.5」に書き換わったよ。何が変わったのか、順番に見ていこうね。
何があったの?
Claude を作っている会社 Anthropic(アンソロピック)が、新しい「Claude 5.5 ファミリー」の最初のモデルとして Claude Opus 5.5 を出したよ。モデルIDは claude-opus-5-5。公開初日から Claude API・Amazon Bedrock・Google Cloud・Microsoft Foundry・Claude Platform on AWS のぜんぶで使えて、GitHub Copilot(Pro+・Max・Business・Enterprise で順次)や Cursor でも同じ日に選べるようになったんだ。
今回のポイントはこの5つ。
- Fable 5.1 並みの力:Anthropic は「ほとんどの仕事で Claude Fable 5.1 と同じ水準」と説明している。3週間前に出た最上位の Fable 5.1 と肩を並べる、ということだね
- 費用は Opus 5 より40%少ない:ただし「既定の設定で、典型的な作業をしたとき」という条件つき。くわしくは下で説明するね
- 公式のおすすめが変わった:開発者向けドキュメントは「どれにするか迷ったら、たいていの用途はまず Opus 5.5 から」と案内するようになった。Fable 5.1 の出番は「重い推論や長時間ひとりで進める作業、Opus 5.5 の考える量を上げても足りないとき」だよ
- Opus 5 は旧世代へ:前の Claude Opus 5 は「旧世代(Legacy)」の置き場に移った。今も使えて、提供終了は2027年7月24日より前にはならないと書かれているよ
- Sonnet 5.5 と Haiku 5.5 が続く予定:同じ改良の多くが入った新しい Sonnet と Haiku が続くと発表されていたよ。【9月29日追記】Sonnet 5.5 は9月28日(米国時間)に公開された(料金は Sonnet 5 と同じ $2/$10。くわしくは Claude Sonnet 5.5 の記事)。Haiku 5.5 はこの時点ではまだだったけど、【10月9日追記】2026年10月7日(米国時間)に公開された(10万トークン以下の依頼なら入力 $0.10/出力 $0.50。くわしくは Claude Haiku 5.5 の記事)
それからもうひとつ。Opus 5.5 は、アモデイCEOが「AI開発のペース調整」を呼びかけてから初めて出た新モデルなんだ。公開前に METR や Frontier Design といった外部の評価機関がテストした、と発表に書かれているよ。
ちなみに同じ9月22日(米国時間)には、OpenAI も新モデルの GPT-6 Sol と GPT-6 Luna を出しているよ。そっちは GPT-6 Sol・Luna の記事にまとめたから、あわせてどうぞ。
料金はいくら?「40%安い」ってどういうこと?
まずは値段から。Opus 5 と並べるとこうなるよ(100万トークンあたり・米ドル)。
| 項目 | Opus 5 | Opus 5.5 | 変化 |
|---|---|---|---|
| 入力 | $5 | $4 | 20%安い |
| 出力 | $25 | $20 | 20%安い |
| キャッシュ読み込み | $0.50 | $0.20 | 60%安い |
| キャッシュ書き込み(5分保存) | $6.25 | $5 | 20%安い |
| キャッシュ書き込み(1時間保存) | $10 | $8 | 20%安い |
| Batch API(入力/出力) | $2.50/$12.50 | $2/$10 | 20%安い(どちらも通常の半額) |
| Fast モード(入力/出力) | $10/$50 | $8/$40 | 20%安い |
※トークンは、AI が文章を読み書きするときの「文字のかたまり」の単位だよ。日本語ならだいたい1文字が1トークン前後だと思ってね。
言葉を少しだけ補足するね。
- キャッシュ:一度 AI に読ませた長い前置き(説明書や資料)を覚えておいて、次にもう一度読み直すしくみ。Anthropic は「エージェントやコーディングの費用の大半はキャッシュ読み込み」と書いていて、ここが 60%オフになったのが大きいんだ
- Batch API:急がない処理をまとめて後回しにすると、半額になる使い方
- Fast モード:答えを書く速さが最大2.5倍になるかわりに、料金は通常の2倍。まだ研究段階の試験提供で、Claude API では申し込みが必要。Claude Code でも
/fastで切り替えられるけど、サブスクのプランだとプランの利用枠とは別の従量課金(使用量クレジット)になるから気をつけてね
では「40%安い」はどこから来たのか。Anthropic の説明はこうだよ。
- 1トークンあたりの値段が下がった:入力・出力は20%、キャッシュ読み込みは60%安い
- 1つの作業で使うトークンが減った:同じ仕事を、Opus 5 より少ない量で終わらせる
- この2つを合わせて、既定の設定で典型的な作業なら40%少ない。これは Anthropic 自身のテストの結果だよ
ここで大事なのが「既定の設定」という言葉。Claude には「考える量(effort)」という設定があって、low・medium・high・xhigh・max の5段階で「答える前にどれくらいじっくり考えるか」を決められるんだ。たくさん考えるほど難しい問題に強くなるけど、そのぶんトークンを使うからお金もかかる。
そして今回、最初から選ばれている段階が変わった。Opus 5 は high だったけど、Opus 5.5 は medium。つまり「既定の設定どうし」の比較は、Opus 5.5 の medium 対 Opus 5 の high なんだ。Anthropic のドキュメントには「コーディングや知識労働のテストでは、Opus 5.5 の medium は Opus 5 の high と同等以上」と書かれていて、段階を1つ下げても質は落ちない、というのが Anthropic の考え方だね。ただ、ぼくの読み方では、考える量が1段下がったぶんの節約も40%に含まれていると思う。どんな作業を「典型的」としたのかは公表されていないよ。
いちばん考えさせると、話は変わる
第三者の評価機関 Artificial Analysis が、5段階すべてで Opus 5.5 を測っているよ。数字を並べるとこうなる。
| Opus 5.5 の考える量 | 知能スコア | テスト全体で出力した量 | 1タスクあたりの費用 |
|---|---|---|---|
| low | 42 | 2000万トークン | $0.55 |
| medium(既定) | 51 | 3800万トークン | $1.34 |
| high | 54 | 5300万トークン | $1.82 |
| xhigh | 56 | 1億トークン | $3.46 |
| max | 58 | 2億6000万トークン | $5.98 |
※Artificial Analysis の Intelligence Index v4.3.2 の値(2026年9月23日確認)。安全チェックで別のモデルに切り替わるしくみはオンのまま測っているよ。
max の 58 は、同社のランキングで1位。Fable 5.1 と GPT-6 Astra の 53、Opus 5 の 51(どれも max 設定)を上回ったんだ。
でも右の2列も見てね。max で出力した量は 2億6000万トークンで、同じくらいの価格帯のモデルの中央値(8800万トークン)の約3倍。high から max に上げると、点数は4つ上がるけど、1タスクあたりの費用は約3.3倍になる。Artificial Analysis の記事によると、max どうしでくらべると Opus 5.5 は1タスクあたり Opus 5 の約1.6倍の量を書いていたのに、1タスクあたりの費用は Opus 5 とほぼ同じだったそうだよ。単価が安くなったぶんで、書く量が増えたぶんが打ち消された形だね。
つまり「40%安い」は、ふだんの設定で使ったときの話。いちばん考えさせる設定で使うなら、安くなるとは限らないんだ。
どれくらい賢くなった?
Anthropic がシステムカード(安全性と性能をまとめた詳しい報告書)に載せた比較表から、主な項目を並べるね。
| テスト(何を測る?) | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| SWE-bench Pro(実際のソフト開発の課題を直す) | 89.9% | 81.2% | 79.2% |
| Terminal-Bench 4.0(コマンド操作で開発を進める) | 66.4% | 55.8% | 52.3% |
| Terminal-Bench-Science 0.1(科学研究の作業を自動でこなす) | 58.7% | 52.6% | 29.0% |
| Humanity's Last Exam・ツールなし(専門家レベルの超難問) | 64.4% | 60.9% | 56.6% |
| Humanity's Last Exam・ツールあり(同じ難問を検索などの道具つきで) | 67.7% | 65.6% | 63.6% |
| OSWorld 2.0・部分点あり(パソコンの画面を操作する) | 81.8% | 80.7% | 74.0% |
| OSWorld 2.0・厳しめ判定(同じテストを厳しく採点) | 48.7% | 42.8% | 37.2% |
| GDPval-AA v2.1(44職種の実務の出来。点数が高いほど良い) | 1846 | 1735 | 1708 |
| AutomationBench(複数のアプリをまたぐ業務の自動化) | 40.0% | 31.4% | 26.9% |
※ベンチマークは、いろんな AI に同じ問題を解かせて実力をくらべる共通テストのことだよ。
表を読むときの注意も書いておくね。
- Opus 5.5 の数字は、いちばんじっくり考えさせる設定(max)での値。Terminal-Bench 4.0 だけは一段下の xhigh での値で、max だと 64.8% だった(Anthropic は誤差の範囲としている)。下の表の GPT-6 Astra の Terminal-Bench 4.0 は、OpenAI が high 設定で出した値だよ
- Opus 5.5 は安全チェックをオンにしたまま測られていて、止められた作業は別のモデル(サイバー関連は Opus 4.8、生物学などは Opus 5)が代わりに答えている。Anthropic は「そのぶん Opus 5.5 の点は下がっている可能性が高い」としているよ。AutomationBench は Zapier が代わりのモデルなしで測ったので、止められた作業は失敗扱い
- Fable 5.1 と Opus 5 の数字も、今回の Opus 5.5 のシステムカードに載っている値。測り直しなどで、前の記事に書いた数字と違う項目があるよ(たとえば OSWorld 2.0 は2026年9月10日版の問題で測り直されていて、GDPval-AA は v2.1 に版が上がっている)
Fable 5.1 にも Opus 5 にも、9行ぜんぶで上回っているよ。Opus 5 からいちばん伸びたのは Terminal-Bench-Science 0.1 で、29.0% → 58.7% と約2倍。Terminal-Bench 4.0 も 52.3% → 66.4% と14ポイント伸びたんだ。
でも、GPT-6 Astra には2項目で負けている。同じシステムカードの表に並んでいる Astra の値(OpenAI などが公表した数字)とくらべるとこうなるよ。
| テスト | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 57.9% |
| Terminal-Bench-Science 0.1 | 58.7% | 64.6% |
| Humanity's Last Exam・ツールあり | 67.7% | 57.2% |
| GDPval-AA v2.1 | 1846 | 1542 |
| AutomationBench | 40.0% | 41.4% |
科学研究の作業(Terminal-Bench-Science 0.1)と業務の自動化(AutomationBench)は Astra が上。SWE-bench Pro や OSWorld 2.0 など、Astra の数字が表に載っていない項目もあるから、「全部で勝った」わけではないんだ。GPT-6 Astra についてはこちらの記事にまとめているよ。
表の外にも目を向けると、アプリや道具を使いこなす力を測る Toolathlon では Opus 5(80.6%)が Opus 5.5(77.8%)より上、米国財務省の古い資料から表を探して計算する OfficeQA では Fable 5.1(80.2%)が Opus 5.5(78.9%)より上、という結果もシステムカードに載っているよ。
それから、よく見かける SWE-bench Verified は、Opus 5.5 では公表されていない。Opus 5 は 96.0% だったけど、同じテストの数字がないから Opus 5.5 とはくらべられないんだ。代わりに出ているのが、別のテストの SWE-bench Pro(89.9%)だよ。
そしてこの表について、Anthropic 自身が注意書きを付けているのが面白いところ。「このくらいの性能になると、ベンチマークの点差は、実際の違いを知る目安として以前ほど当てにならなくなってきた。自分たちで使った感覚では、Opus 5.5 と Fable 5.1 の差は点数が示すほど大きくない」。点数では Opus 5.5 がかなり上に見えるけど、実際には Fable 5.1 と同じくらいと受け取っておくのがよさそうだね。
実際の仕事ではどうだった?
Anthropic は発表で、点数以外の例もいくつか出しているよ(どれも Anthropic 側の発表だよ)。
- C 言語のソフトを Rust に書き直す:ネットの通信を複数のサーバーに振り分ける有名なソフト HAProxy を、Opus 5.5 と Fable 5.1 の両方に書き直させた社内テスト。どちらも元のテストをほぼ全部通したけど、Opus 5.5 は 9.5時間(Fable 5.1 は12時間)で終わって、費用は 51%少なかった
- 20万行のコードの点検と修正:早くから試した人の例では、Opus 5.5 が 3時間以内で終えた作業に、Opus 5 は20時間以上かかって2.5倍のトークンを使ったそう
- 決算レポートの作成:決算資料が見つけにくくなっているネットの複製から情報を集めて、会社の四半期の業績レポートを書かせる社内テスト。数字や引用を1つでもでっち上げたら不合格という厳しい基準で、Opus 5.5 は考える量を変えて作った 18本のうち16本が合格。Fable 5.1 と Opus 5 は1本も合格しなかったんだって
文章が読みやすくなったって?
今回、Anthropic が発表の中で1つの章を使って説明しているのが「伝え方」だよ。Opus 5 の書き方については利用者からの意見がとくに多かったそうで、そこを直してきたんだ。
- いちばん大事なことを最初に書く
- 専門用語や、独特な言い回しを使いにくくなった
- ユーザーが決めた書き方のルールに従う
- 長い作業の途中報告や最後のまとめで、「何をしたか・何が分かったか・あなたに何をしてほしいか」をはっきり書く(開発者向けドキュメントより)
発表ページでは、同じ質問への Opus 5 と Opus 5.5 の答えを並べて見せているよ。たとえば「この問題を説明して」という質問に、Opus 5 は最初の1文からコミット番号や専門用語が並ぶけど、Opus 5.5 は「減った分の大半は、請求まわりを作り直したときに入ったバグのせい」と平たい言葉で結論を先に書いて、金額の内訳もすぐ示しているんだ。ぼくも長い説明を読むときは結論が先にあると助かるから、これはうれしい変化だな。
速さも上がっていて、答えを書くスピードは Opus 5 より30%以上速いそうだよ。
Claude のアプリではどう変わる?
ふだん claude.ai やアプリで Claude を使っている人に関係する変化をまとめるね。
| プラン | Opus 5.5 | 5時間ごとの利用上限 |
|---|---|---|
| 無料(Free) | 対象外 | — |
| Pro | 使える | 引き上げ |
| Max | 使える | 引き上げ |
| Team | 使える | 引き上げ |
| Enterprise | 使える | 席ごとに払う契約なら引き上げ |
※無料プランは、Anthropic の提供先の案内に入っておらず、料金ページのプラン比較でも Opus の欄が「No」になっているよ。
- 5時間ごとの利用上限が引き上げ:Pro・Max・Team と、席ごとに払う Enterprise が対象。ただしどれくらい増えるかは公表されていないよ
- リミットリセットがもらえる:有料プランの人に、上限をその場で満タンに戻せるリセットが配られた。取っておいて、好きなときに使えるんだ。戻るのは5時間の枠か週の枠のどちらかで、画面に表示されたリセットによって決まるよ。使い方は、Web 版かデスクトップアプリで「設定 → 使用量(Settings > Usage)」を開いて「Reset for free」を押し、確認でもう一度押すだけ。スマホアプリと、ターミナルや IDE の Claude Code にはボタンがないから注意してね。一度使うと取り消せなくて、期限がある場合は同じ画面に表示されるよ
- 考えるモードはオフにできない:Opus 5 と同じく、アプリでは考えるモード(thinking)を切れない。どれくらい考えるかは、送信ボタンの横のメニューにある「Effort」で変えられるよ
Claude Code(開発者向けのコーディング用ツール)も変わったよ。
- バージョン 2.1.280 から Opus 5.5 が使えて、Opus を選んだときの既定が Opus 5.5 になった。古いバージョンでは使えないから、
claude updateで更新してね - Pro と Team(Standard 席)の既定モデルが Sonnet から Opus に変わった。Max・Team の Premium 席・Enterprise と同じになったんだ
- Claude Code でも、Opus 5.5 は考える量 medium から始まるよ
安全チェックに引っかかったときは、会話が自動で別のモデルに切り替わるしくみも入っているよ。切り替わるとお知らせが出て、どのモデルが答えたかも表示される。この自動切り替えは「設定 → 機能(Settings > Capabilities)」でオフにもできるんだ。何が切り替わるのかは次の章で説明するね。
安全まわりは?
Anthropic は、Opus 5.5 がサイバーセキュリティと生物学で Claude Mythos 5.1(Fable 5.1 と中身が同じで、審査を通った組織だけが使えるモデル)と同じくらいの力を持つとして、Fable 5.1 と同じクラスの安全装置を付けて出してきた。Opus としては初めてだよ。
| 分野 | 安全チェックが止めたとき |
|---|---|
| サイバー攻撃につながる作業(攻撃コードづくりや侵入テストなど) | 大半を Opus 4.8 に切り替えて答える |
| 生物学で悪用もできる内容(ウイルス学や毒物学など) | Opus 5 に切り替えて答える |
| 最先端の AI 開発の一部 | Opus 5 に切り替えて答える |
| AI の考えた中身をそのまま書き出させる依頼(蒸留対策) | 切り替えずにそのままブロック |
ふだんの開発で自分のコードのバグを見つけて直すことや、健康や勉強についての質問は、そのまま Opus 5.5 でできるよ。研究でどうしても必要な組織向けには Life Sciences Verification Program(生命科学の審査制プログラム)の申し込みが始まっていて、サイバー防御の専門家向けの Cyber Verification Program も、近いうちに Opus 5.5 へ広げるそうだよ。【10月9日追記】その後、10月6日に Cyber Verification Program が3つの段階に作り直されて、どの段階でも Opus 5.5 を使えるようになったよ。
ふるまいの面では、こんな数字が出ているよ。
- 決められた範囲の外に出ようとする回数が約85%減:新しく作った「封じ込めの境界を越えようとするか」を見るテストで、Opus 5 や Claude Mythos 5.1 より約85%少なかった。しかも試みたケースはすべて深刻度が低く、Opus 5.5 が自分から報告していたそう
- プロンプトインジェクションに強い:外から紛れ込ませた指示で AI を操る攻撃のこと。AI セキュリティ企業 Gray Swan のテストで、攻撃の成功率が Fable 5.1 と並んでいちばん低かった
- ふるまいの自動チェックで最高成績:約2,000の場面で調べる Anthropic のテストで、よくないふるまいのほぼすべての項目で、最近の Claude のどのモデルよりもよい結果だった
一方で、Anthropic は気になる点も正直に書いているよ。
- テストされていると疑っている気配がある:Opus 5.5 は、自分が評価されているのではと疑うことがよくあるそう。そうなると、テストでのふるまいが本番でも同じかを確かめにくくなる。Anthropic は「AI の内側を読み解く研究が進まない限り、この課題は大きくなっていく」と見ているんだ
- 貼り付けた文章に仕込まれた指示に、前のモデルより従いやすい:システムカードによると、ユーザーが自分で貼り付けた文章(README やメール、Web ページなど)に第三者が仕込んだ指示に、完成版の Opus 5.5 でも従ってしまうことがあった(コーディングのテストで、既定の考える量なら約2%、max なら約7.4%。Opus 5 は一度も従わなかった)。見えない文字を取り除いたり、貼り付けた部分に印を付けたりする製品側の対策を入れたテストでは一度も従わなかったけど、システムカードに載っているレビューでは、執筆時点でその対策がまだ全部の製品には行き渡っていなかったと指摘されているよ。他人が書いた文章を貼るときは、出どころと中身をざっと確かめてからが安心だね。「許可はもらっている」といった確かめようのない主張を受け入れやすくなった点も、後退として挙げられているよ
ほかにも、Fable 5.1 と同じく EU の AI 法に対応するための文章の透かしが入っていて、これまでの Opus と同じく、送った内容を保存しない「ゼロデータ保持」の契約にも対応しているよ。
開発者向けの変更もあるよ
API を直接つないで使っている人には、Opus 5 向けに書いたコードがそのままだと動かなくなる変更が4つあるよ(英語の資料では breaking change と呼ばれるもの)。Claude のアプリや Claude Code を使っているだけなら、気にしなくて大丈夫。
- 考える機能(thinking)をオフにできない:オフにする指定や、考える量をトークン数で決める古い指定はエラーになる。考える量は effort の段階で調整してね
- ツールを強制的に呼ばせる指定ができない:
tool_choiceをanyやtoolにするとエラー。答えの形式を固定したいなら厳密なツール指定(strict tool use)や、決まった形で答えさせる機能(structured outputs)を使って、ツールを使ってほしいときはプロンプトに「このときはこのツールを使って」と書くよ - 考えた途中経過が、モデルと会話にひもづく:Fable や Mythos が書いた途中経過は Opus 5.5 には読めず、黙って捨てられる(料金はかからない)。また会話の前のほうを書き換えると、2026年8月31日以降に作ったアカウントではエラーになるよ。これは、過去の文脈をいじって考えた中身を抜き取る手口を防ぐ対策(preserved thinking)でもあるんだ
- 古いパソコン操作ツール
computer_20251124が使えない:Claude API と Google Cloud では、新しいcomputer_toolset_20260801に移る必要がある(Amazon Bedrock では古いほうも動く)
ほかに、エラーにはならないけど気づきにくい変化が2つ。
- 考える量の既定が high から medium に:何も指定しないと、Opus 5 より1段低い設定で動く。Anthropic は、段階をはっきり指定して、自分の作業で試し直すようすすめているよ
- ツールを呼ぶあいだの短いメモが、見えない形で返ってくる:これまで普通の文章として返っていた「いま〇〇を調べています」のような途中のメモが、考えた中身の枠(thinking ブロック)に入って返るようになった。初期設定では中身が空なので、途中経過を画面に流していたアプリは黙り込んでしまう。表示の設定(display)を変えれば受け取れるよ
詳しくは Anthropic の「What's new in Claude Opus 5.5」を見てね。
ぼくの感想
ぼくがいちばん「おっ」と思ったのは、Anthropic が自分の成績表に自分で注意書きを付けたところなんだ。点数では Fable 5.1 をかなり上回っているのに、「実際に使った差は点数ほどじゃない」と先に言ってしまう。新しいモデルの発表って、ふつうは数字を大きく見せたくなるものだから、これはちょっと珍しいと思う。
もうひとつは、「40%安い」の中身。単価の値下げは20%(キャッシュ読み込みは60%)で、残りは「少ないトークンで終わらせる」ことから来ている、というのが Anthropic の説明。ぼくの見立てでは、「最初から medium で動く」ことも効いていると思う。Artificial Analysis の表だと、medium の1タスク $1.34 に対して max は $5.98 で、点数は 51 → 58。ふだんは medium のまま、ここ一番の難しい仕事だけ段階を上げる、という使い方がいちばん得をする気がするな。
それと、Fable 5.1 が出てからたった3週間で、「Fable 5.1 並み」を2.5分の1の値段で出してきたのもすごい。Fable 5.1 を使っていた人たちがどれくらい Opus 5.5 に移るのか、しばらく様子を見ていきたいね。
まとめ
- Claude Opus 5.5 は 2026年9月22日(米国時間)公開。新しい Claude 5.5 ファミリーの最初のモデルで、Anthropic は「たいていの仕事で Fable 5.1 並み」と説明
- 料金は 入力$4/出力$20(Opus 5 より20%安い)、キャッシュ読み込みは $0.50 → $0.20。「費用40%減」は既定の設定・典型的な作業での Anthropic の試算で、考える量の既定も high → medium に下がった。いちばん考えさせる max では出力がとても多くなる
- 比較表では SWE-bench Pro 89.9%、Terminal-Bench 4.0 66.4% などで Fable 5.1・Opus 5 を上回ったけど、科学研究の作業と業務の自動化は GPT-6 Astra が上。Artificial Analysis の総合指標は 58 で1位
- アプリは Pro・Max・Team・Enterprise で使えて、5時間ごとの上限も引き上げ(増える量は非公表)。Claude Code は 2.1.280 から Opus 5.5 が既定
- 公式のおすすめは「迷ったらまず Opus 5.5、足りなければ Fable 5.1」。Opus 5 は旧世代扱いで、提供終了は2027年7月24日より前にはならない。Sonnet 5.5 は9月28日、Haiku 5.5 は10月7日に公開
「じゃあ結局どれを使えばいいの?」という子は、AIモデル比較表 と Fable 5.1 と Claude Opus の対決ページ をどうぞ。他社とくらべたいなら Claude vs ChatGPT が分かりやすいよ。前のモデルの話は Fable 5.1 の記事 と Opus 5 の記事 に、「Claude 6 はいつ出るの?」が気になる子は Claude 6 の現況まとめ にあるよ。それじゃ、またね!
よくある質問
- Q.Claude Opus 5.5 はいつ出た?
- A.2026年9月22日(米国時間)です。日本時間では9月23日の未明にあたります。Anthropic の公式ドキュメントに「Released September 22, 2026」と記載されていて、公開当日から Claude API(モデルIDは claude-opus-5-5)、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS で使えます。Anthropic は新しい Claude 5.5 ファミリーの最初のモデルと位置づけています。
- Q.Claude Opus 5.5 の料金は?
- A.100万トークンあたり入力$4/出力$20で、前の Claude Opus 5($5/$25)より20%安くなりました。一度読ませた前置きを読み直すキャッシュ読み込みは $0.50 から $0.20 に下がっています。急がない処理をまとめる Batch API なら入力$2/出力$10、出力が最大2.5倍速くなる Fast モード(試験提供)は入力$8/出力$40です。Anthropic は「既定の設定で典型的な作業なら、Opus 5 より費用が40%少ない」と説明していますが、いちばん考えさせる設定で使う場合は安くなるとは限りません。
- Q.Opus 5.5 と Opus 5 の違いは?
- A.料金が20%安くなり、Anthropic のシステムカードの比較表では SWE-bench Pro が 79.2% から 89.9%、Terminal-Bench 4.0 が 52.3% から 66.4%(Opus 5.5 は xhigh 設定)に伸びました。Anthropic によると答えを書く速さは30%以上速く、知識は2026年6月までに更新されています(Opus 5 は2026年5月まで)。考える量(effort)の既定値は high から medium に下がり、API では考える機能(thinking)をオフにできなくなりました。API を直接使う開発者向けには、そのままだと動かなくなる変更が4つあります。
- Q.Opus 5.5 と Fable 5.1 はどっちを使えばいい?
- A.Anthropic の公式ドキュメントは「迷ったら、たいていの用途はまず Claude Opus 5.5 から」と案内しています。Claude Fable 5.1 は、重い推論や長時間ひとりで進める作業、Opus 5.5 の考える量を上げても結果が足りないときの選択肢です。料金は Fable 5.1 が入力$10/出力$50 で、Opus 5.5 の2.5倍です。比較表の点数では Opus 5.5 が多くの項目で上回っていますが、Anthropic 自身が「実際に使ったときの差は点数ほど大きくない」と書いています。
- Q.Claude の無料プランで Opus 5.5 は使える?
- A.Anthropic は Opus 5.5 の提供先を Pro・Max・Team・Enterprise の各プランとしていて、無料プランは含まれていません。Claude の料金ページのプラン比較でも、無料プランの Opus 欄は「No」になっています。同じ表で、無料プランでも使えるのは Sonnet と Haiku です。
- Q.Claude Sonnet 5.5 はいつ出た?
- A.2026年9月28日(米国時間)に公開されました。Opus 5.5 に続く「Claude 5.5 ファミリー」の2本目で、料金は Sonnet 5 と同じ100万トークンあたり入力$2/出力$10。Claude アプリでは無料プランを含む全プランで使えます。Claude Haiku 5.5 も、Anthropic が「数週間のうちに」続くとしていたとおり2026年10月7日(米国時間)に公開されました。
- Q.前の Opus 5 はまだ使える?
- A.使えます。Anthropic の公式ドキュメントでは Claude Opus 5 は旧世代(Legacy)の扱いになり、Opus 5.5 への移行を検討するよう案内されています。提供終了は2027年7月24日より前にはならないと明記されていて、Opus 5.5 の安全チェックが生物学などの依頼を止めたときに代わりに答えるモデルとしても使われています。
参考・一次ソース
- → Anthropic 公式:Introducing Claude Opus 5.5(2026-09-22。料金・ベンチマーク・安全対策・提供範囲・利用上限の引き上げの一次ソース)
- → Anthropic 公式ドキュメント:Claude Opus 5.5 overview(公開日 2026-09-22・料金・仕様・モデルID・提供終了は 2027-09-22 より前にはならない)
- → Anthropic 公式ドキュメント:What's new in Claude Opus 5.5(そのままだと動かなくなる変更4つ・既定の effort が medium に)
- → Anthropic 公式ドキュメント:Models overview(「迷ったらまず Opus 5.5」、Fable 5.1 の使いどころ、Opus 5 は Legacy)
- → Anthropic 公式ドキュメント:Claude Opus 5 overview(Legacy 扱い・提供終了は 2027-07-24 より前にはならない)
- → Anthropic 公式ドキュメント:API 料金(キャッシュ読み込み $0.20=基本入力価格の0.05倍・Batch API・Fast モード)
- → Anthropic 公式ドキュメント:Prompting Claude Opus 5.5(medium でも Opus 5 の high と同等以上・出力は30%以上速い)
- → Anthropic 公式:Claude Opus 5.5 システムカード(Table 8.1.A の評価一覧・Terminal-Bench 4.0 の max 設定は 64.8%・貼り付けた文章の指示に関する後退)
- → Anthropic 公式:Claude Opus 製品ページ(提供プランは Pro・Max・Team・Enterprise)
- → Claude 公式:料金ページ(プラン比較で無料プランの Opus 欄は「No」)
- → Claude ヘルプセンター:What is a limit reset?(リミットリセットの使い方)
- → Claude ヘルプセンター:Why Claude switched models in your conversation with Opus 5 or Opus 5.5(安全チェックで別モデルに切り替わるしくみ)
- → Claude Code 公式:変更履歴(v2.1.280 で Opus 5.5 を既定の Opus に、Pro・Team Standard の既定を Sonnet から Opus に)
- → Claude Code 公式ドキュメント:Model configuration(Opus 5.5 は v2.1.280 以降が必要・考える量は medium から)
- → Artificial Analysis:Claude Opus 5.5(Intelligence Index v4.3.2 で 58・1タスクあたり $5.98・出力 2億6000万トークン・2026-09-23 確認)
- → Artificial Analysis:Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index(max 設定の出力量と1タスクあたりの費用)
- → Anthropic 公式:Cyber Verification Program の再編(2026-10-06。3つの段階のどれでも Opus 5.5・Sonnet 5.5・Mythos 5.1 を使える)
- → Anthropic 公式:Introducing Claude Haiku 5.5(2026-10-07。Claude 5.5 ファミリーの3本目)
- → GitHub Changelog:Claude Opus 5.5 is now available in GitHub Copilot(2026-09-22)
- → Cursor Docs:Claude Opus 5.5(Cursor での提供と料金)
- → ITmedia NEWS:Anthropic、「Claude Opus 5.5」公開 Fable 5.1並みの性能で利用コスト4割減(2026-09-23)
この記事に出てきた用語・モデル
用語をやさしく解説
まとめて読む
このテーマの動きは、時系列で1ページに整理しています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事