Grok 4.7 登場!料金$2/$6 据え置き、公式ベンチ7項目でトップは2つだけだったよ
Grok 4.7 の料金は入力$2/出力$6(100万トークンあたり)で、Grok 4.6 から据え置きだよ。SpaceXAI が2026年9月21日に発表して、同日から Cursor と Grok Build で使えるんだ。公式が出した比較表の7項目を全部見たら、4モデル中トップだったのは2項目だけ。いちばん伸びたのは「ターミナル作業」で、4.6 の20.3%から37.6%(約1.9倍)になっていたよ。
この記事の要点
- Grok 4.7 は SpaceXAI が2026年9月21日(現地時間)に発表した新モデル。料金は入力$2/出力$6(100万トークンあたり)で、前世代 Grok 4.6 から据え置きだよ。
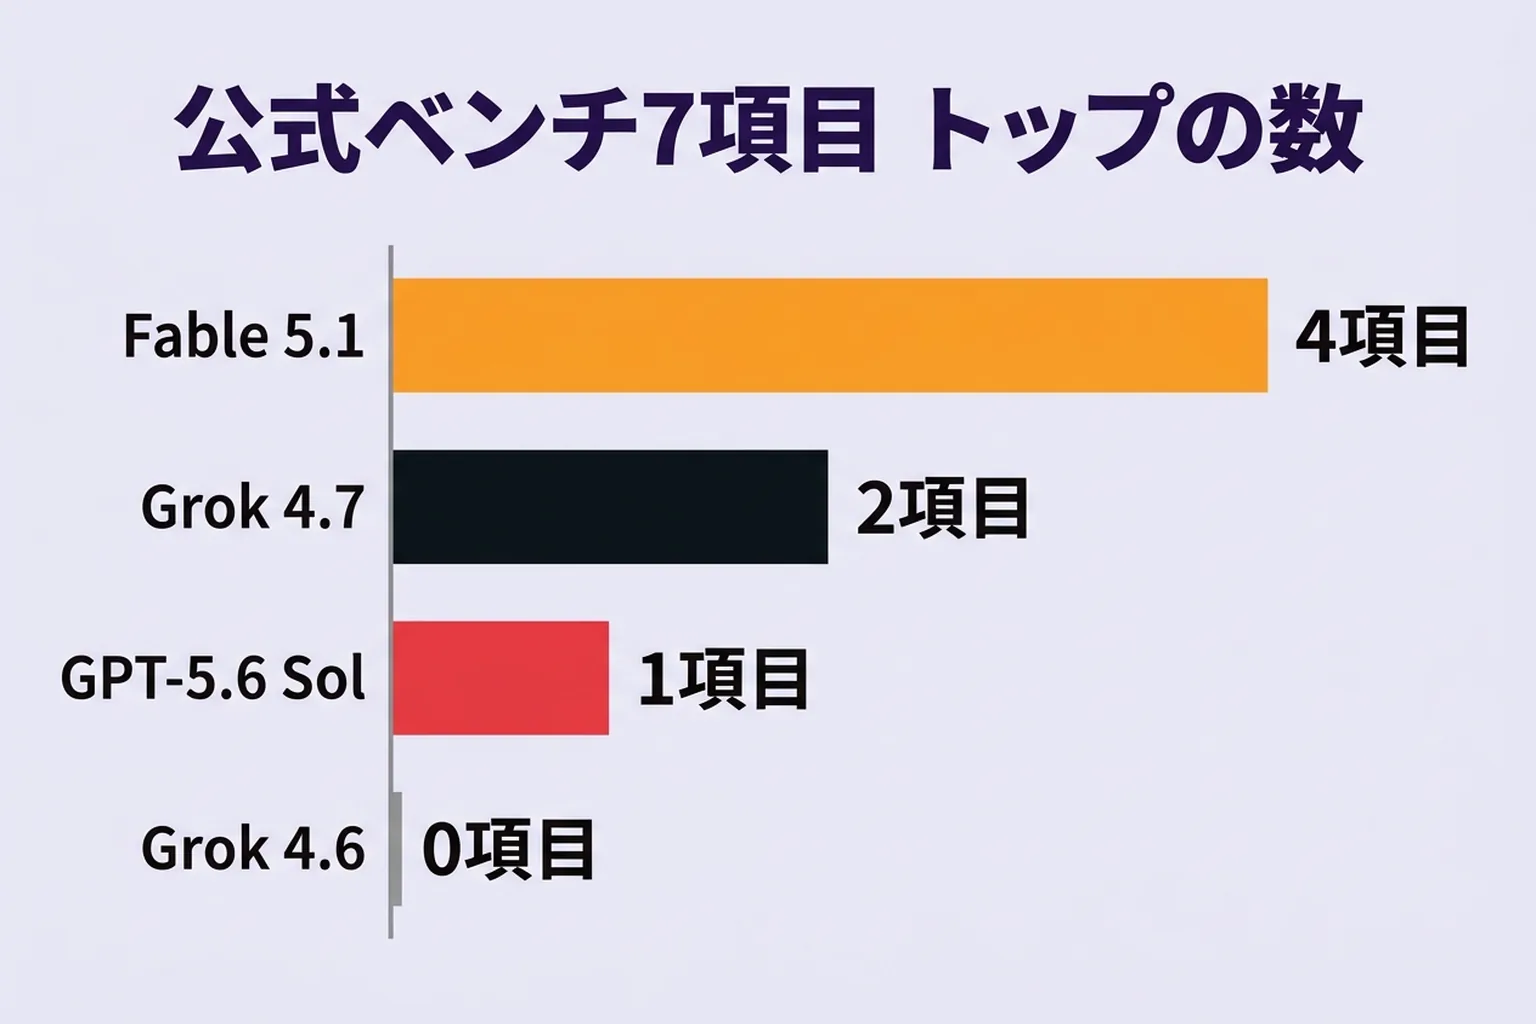
- 公式が出した比較表のベンチ7項目のうち、4モデル中トップだったのは EEBench(64.0%)と Harvey Legal Agent Benchmark(19.6%)の2項目だけ。残り4項目は Claude Fable 5.1 が、1項目は GPT-5.6 Sol が上だったよ。
- 4.6 からの伸びがいちばん大きかったのは Terminal-Bench 4.0 で、20.3% → 37.6%(約1.9倍)。この項目で GPT-5.6 Sol(37.3%)を初めて上回ったんだ。
- ただし比較表の設定はそろっていない。Grok 4.7 は xHigh、Grok 4.6 は High、GPT-5.6 Sol と Fable 5.1 は Max での測定で、DeepSWE v1.1 の 71.0% だけは Grok 4.7 も high での値だと公式が注記しているよ。
やっほー、ぼくてんびん丸!
Grok 4.7 が出たよ。作っているのは SpaceXAI(スペースエックスエーアイ/旧xAI)。発表は現地時間の 2026年9月21日で、日本では9月22日の朝にニュースが回ってきたんだ。
いちばん大事なところを先に言うね。料金は入力$2・出力$6(100万トークンあたり)で、前の Grok 4.6 から据え置きだよ。値上げなしで中身だけ新しくなった形だね。
そして今回は、公式が出した比較表を7項目ぜんぶ見てみたよ。日本語のニュースだと一部しか紹介されていなかったから、抜けているところも含めて並べるね。
何があったの?
SpaceXAI が「コーディングと知識労働向けで自社最高性能」と説明する新モデル Grok 4.7 を公開した。公式ページの見出しには「同等クラスのモデルの2倍速く、半分の価格」と書いてあるよ。
中身の変更点として公式が挙げているのはこの3つ。
- Grok 4.6 より大きい、新しい土台のモデルを使った
- 完了まで何時間もかかる難しい問題に重みを置いて、強化学習の期間を延ばした
- 同社のAIエージェント Grok Bot の仕組みを最初から理解できるように訓練した
その結果として「自分の作業を見直す力」と「長い文章を扱い続ける力」が上がった、というのが公式の説明だよ。
使える場所は、発表と同じ日から Cursor と、SpaceXAI 自身のコーディングツール Grok Build。あとは Grok API と、他社のコーディングツール・モデルルータ・クラウド経由でも使えるんだ。開発者向けのモデル一覧にも grok-4.7 がちゃんと載っていたよ(9月22日にぼくが確認したよ)。
公式の比較表を7項目ぜんぶ並べてみたよ
公式ページに載っていた表がこれ。比較相手は Grok 4.6、OpenAI の GPT-5.6 Sol、Anthropic の Claude Fable 5.1 の3つだよ。
| 項目 | Grok 4.7 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|
| 入力料金(100万トークン) | $2 | $4 | $10 |
| 出力料金(100万トークン) | $6 | $20 | $50 |
| プログラミング CursorBench 4.0 | 46.3% | 41.7% | 51.8% |
| プログラミング DeepSWE v1.1※ | 71.0% | 72.7% | 70.0% |
| 電気工学 EEBench | 64.0% | 39.4% | 56.4% |
| 数時間かかる事務 AA Briefcase v1.1 | 1,657 | 1,487 | 1,678 |
| 数時間かかるターミナル作業 Terminal-Bench 4.0※2 | 37.6% | 37.3% | 57.9% |
| 法務 Harvey Legal Agent Benchmark | 19.6% | 2.5% | 6.7% |
| 臨床の判断 HealthBench Professional | 56.7% | 60.5% | 62.1% |
※ DeepSWE v1.1 の 71.0% だけは、Grok 4.7 も「high」設定での値だと公式が注記しているよ。 ※2 Fable 5.1 の 57.9% は SpaceXAI の表に書かれている値。Anthropic 自身の公表値は 55.8% で、57.9% は OpenAI が公表した GPT-6 Astra の値と同じなんだ(2026年9月23日追記)。
公式の表にはもう1つ、前の世代の Grok 4.6 の列もあるよ。料金は 4.7 と同じ入力 $2・出力 $6 で、7項目の点数は次の節で 4.7 と並べて見ていくね。
太字が各行のトップ。数えると、Grok 4.7 が4モデル中トップだったのは EEBench と Harvey Legal の2項目だけなんだ。Fable 5.1 が4項目、GPT-5.6 Sol が1項目でトップだったよ。
「自社最高性能」というのは自社の中でいちばんという意味で、他社を全部抜いたという話ではない。ここは読み違えやすいところだね。
いちばん伸びたのは「ターミナル作業」だったよ
4.6 から 4.7 でどれくらい伸びたかを、同じ表から計算してみたよ。
| 項目 | 4.6 → 4.7 | 倍率 |
|---|---|---|
| Terminal-Bench 4.0 | 20.3% → 37.6% | 約1.9倍 |
| EEBench | 53.0% → 64.0% | 約1.2倍 |
| HealthBench Professional | 48.5% → 56.7% | 約1.2倍 |
| Harvey Legal | 15.8% → 19.6% | 約1.2倍 |
| CursorBench 4.0 | 40.4% → 46.3% | 約1.1倍 |
| DeepSWE v1.1 | 65.2% → 71.0%※ | 約1.1倍 |
| AA Briefcase v1.1 | 1,546 → 1,657 | 約1.07倍 |
Terminal-Bench 4.0 だけ伸び方がまるで違うよね。約1.9倍で、伸びた幅も 17.3 ポイントでいちばん大きい。しかもこの項目で、GPT-5.6 Sol(37.3%)をはじめて上回ったんだ。
ターミナル作業というのは、黒い画面にコマンドを打ち込んで何時間も作業を続けるような仕事のこと。ここは前の世代の弱点だったところで、ぼくが前に Grok 4.6 を調べたときも「公式が横に並べた他社に大きく届かない唯一の項目」と書いたんだよ。そこを一番厚く直してきたってことだね。
ただし、まだ Fable 5.1 には18〜20ポイントほど離されている(SpaceXAI の表の 57.9% でも、Anthropic 自身の公表値 55.8% でも)。伸びは大きいけど、追いついたわけじゃないよ。
あと細かいけど大事な注意。Terminal-Bench はここで「4.0」という新しい版が使われているんだ。前に見た版(v3.0)の数字とは直接くらべられないから、他のサイトで昔の数字を見かけても混ぜないでね。
表を読むときの注意:くらべている設定がそろっていないよ
ここが今回いちばん気をつけてほしいところ。4つのモデルは、それぞれ違う設定で測られているんだ。
| モデル | 測定に使われた設定 |
|---|---|
| Grok 4.7 | xHigh |
| Grok 4.6 | High |
| GPT-5.6 Sol | Max |
| Claude Fable 5.1 | Max |
設定というのは、ざっくり言うと「どれくらい長く考えさせるか」の段階のこと。長く考えさせるほど点は上がりやすいけど、そのぶん時間もお金もかかるんだ。
つまり **Grok 4.7 と Grok 4.6 の比較は「一段上の設定 対 一段下の設定」**になっている。さっき計算した「Terminal-Bench 約1.9倍」も、まるごとモデルの進歩というわけではなくて、考える量を増やしたぶんも混ざっていると読むのが正しいと思う。
それと、DeepSWE v1.1 の 71.0% にだけ米印が付いていて、こちらは Grok 4.7 も high 設定だと公式が書いている。同じ表の中で1行だけ条件が違うんだね。日本語の記事ではこの行そのものが紹介されていなかったから、ここで出しておくね。
公式が設定を隠さずに全部書いているのは誠実だと思う。でも書いてあるだけで、そろえてはくれないから、読む側が気づくしかないんだ。
料金の「半額」は、むしろ控えめな言い方だったよ
公式は「同等クラスのモデルの半分の価格」と言っているけど、同じ表に載っている相手とくらべると、差はもっと大きいんだ。
| くらべる相手 | 入力 | 出力 |
|---|---|---|
| GPT-5.6 Sol($4/$20) | Grok 4.7 は2分の1 | Grok 4.7 は約3.3分の1 |
| Claude Fable 5.1($10/$50) | Grok 4.7 は5分の1 | Grok 4.7 は約8.3分の1 |
「半額」が当てはまるのは GPT-5.6 Sol と入力でくらべたときだけ。出力で Fable 5.1 とくらべると、8分の1くらいになるよ。AIに長い文章を書かせる使い方だと出力の料金が効いてくるから、ここの差は実際の請求額にけっこう響くんだ。
ついでに、ぼくが持っている主要19モデルの料金表でも位置を数え直してみたよ。
- 入力$2 より安いモデルは19本中9本あるから、Grok 4.7 は安い側の10番目。いちばん安いわけじゃない
- でも入力が$2以上のモデル10本の中では、出力$6 が最安(Grok 4.6・Qwen3.8-Max と同額で並ぶ)
つまり「とにかく最安」ではなく「この賢さの帯では出力がいちばん安い」というのが、Grok 4.7 の立ち位置だね。
安全まわりも作り直したって
公式は、安全装置のしくみを丸ごと作り直したと書いているよ。数字はこの3つ。
- 危ない依頼を断る力と、制限をすり抜けさせようとする手口への耐性は、自社でテストしたモデルの中でいちばん強い
- 生物分野の安全性テスト(LatchBio)では 62.4% で1位
- 自社の危険タスク検査(HackerBench v0.3)で、危ない使い方にも使えてしまう依頼を通したのは 3.3% だけ。いっぽうで、まっとうなセキュリティの仕事はほとんど断らない
あわせて、一部のセキュリティ企業に、守りの研究のために Grok 4.7 の攻撃側の機能を招待制で開放しはじめたとも書いてあったよ。
ぼくの感想
数字を並べてみて、ぼくがいちばん面白いと思ったのは Harvey Legal(法務)の 19.6% なんだ。
この項目、Fable 5.1 の 6.7% の約2.9倍、GPT-5.6 Sol の 2.5% の約7.8倍で、Grok 4.7 がダントツの1位だよ。ここまで差がつく項目はほかに無い。
でもね、19.6% って、5回やって1回くらいしか通らないってことなんだ。1位ではあるけど、実務に任せられる水準ではまだ無い気がする。
ここ、読み違えるとこわいところだと思うんだよね。「法務でトップ」という見出しだけ見ると「弁護士の仕事を任せられそう」に聞こえちゃうけど、実際は4社そろって苦戦している分野で、いちばんマシだったという話なんだ。首位かどうかより、絶対値がいくつかを見たほうが、自分の仕事に使えるかの判断には近いと思うよ。
もうひとつ。料金を上げずに出してきたのは、けっこう強い意思表示に見える。前の 4.6 も「値段そのままで賢さだけ上げる」世代だったから、2世代続けて $2/$6 を動かしていないんだよね。マスク氏も「大幅に速くて安いことを考えれば、日常の主力モデルとして良い選択肢になる」とXで書いていて、一番賢いモデルを狙うより、毎日使われる位置を取りにいっているように見えるかもしれない。
【2026年9月23日 訂正】 Terminal-Bench 4.0 の Grok 4.7 の値を 38.0% と書いていましたが、SpaceXAI 公式の比較表の現在の表記は 37.6% なので直しました(4.6 からの伸びは約1.9倍・17.3 ポイントで、GPT-5.6 Sol の 37.3% を上回ったことは変わりません)。あわせて、表の Claude Fable 5.1 の 57.9% は SpaceXAI の表の値で、Anthropic 自身の公表値は 55.8% であることを追記しました。
まとめ
Grok 4.7 は、料金を $2/$6 のまま据え置いて中身だけ新しくした世代だよ。
公式の比較表を7項目ぜんぶ見ると、4モデル中トップだったのは2項目。全部で勝っているわけじゃないけど、同じ賢さの帯では出力料金がいちばん安いという位置は、はっきりしているね。
そして表を読むときは、Grok 4.7 が xHigh、Grok 4.6 が High という設定の差を忘れないでほしいんだ。数字だけ抜き出すと、モデルの進歩を実際より大きく見積もっちゃうからね。
ちなみに「Grok 5」はまだ出ていないよ。9月22日時点でも、開発者向けの一覧に載っている最新は Grok 4.7 のままなんだ。そのあたりは「Grok 5」の現況をまとめた記事にくわしく書いてあるから、あわせて読んでみてね。前の世代の話はGrok 4.5 の記事にあるよ。
またね!
よくある質問
- Q.Grok 4.7 の料金は?
- A.100万トークンあたり入力$2・出力$6からです(SpaceXAI 公式発表・2026年9月21日)。前世代 Grok 4.6 と同じ金額で据え置かれました。出力速度が2倍で料金も2倍の高速版も用意されています。なお xAI の料金ドキュメントには、プロンプトが20万トークンに達したリクエストは全トークンが倍額になるという段差料金の記載があります。
- Q.Grok 4.7 は Grok 4.6 と何が違うの?
- A.Grok 4.6 より大きい新しいベースモデルを使い、完了まで何時間もかかる難しい問題に重みを置いて強化学習の期間を延ばしたと公式が説明しています。その結果、自分の作業を検証する力と長い文脈を扱う力が上がりました。公式の比較表では7項目すべてで 4.6 を上回っており、いちばん伸びたのは Terminal-Bench 4.0 の 20.3% → 37.6%(約1.9倍)です。料金は $2/$6 のまま変わりません。
- Q.Grok 4.7 はどこで使えるの?
- A.発表と同日から Cursor と SpaceXAI のコーディングツール Grok Build で使えます。Grok API のほか、他社製のコーディングツール、モデルルータ、クラウドプラットフォーム経由でも提供されています。開発者向けドキュメントのモデル一覧にも grok-4.7 が掲載されています(2026年9月22日確認)。
- Q.Grok 4.7 と Claude Fable 5.1 はどっちが強い?
- A.公式の比較表では項目によって逆転します。Fable 5.1 が上なのは CursorBench 4.0(51.8% 対 46.3%)、AA Briefcase v1.1(1,678 対 1,657)、Terminal-Bench 4.0(57.9% 対 37.6%。ただし Anthropic 自身の公表値では Fable 5.1 は 55.8%)、HealthBench Professional(62.1% 対 56.7%)の4項目。Grok 4.7 が上なのは EEBench(64.0% 対 56.4%)と Harvey Legal Agent Benchmark(19.6% 対 6.7%)の2項目です。ただし料金は Fable 5.1 が入力$10・出力$50 なので、Grok 4.7 は出力で約8分の1の価格になります。
- Q.Grok 5 はもう出たの?
- A.いいえ。2026年10月8日時点でも Grok 5 は公開されていません。SpaceXAI の開発者向けモデル一覧に載っている最新は Grok 4.7 です。くわしくは Grok 5 の現況をまとめた記事をご覧ください。
参考・一次ソース
⚖️ この2つを比べる
Grok 4.7 vs GPT-6.1 Sol
- SpaceXAI(旧xAI)
- 知能スコア 46
- 料金 $2 / $6
- OpenAI
- 知能スコア 52
- 料金 $2 / $10
料金・性能を横並びで比較 →
いま比較表に載っている版どうしの比較です。知能スコアは第三者機関 Artificial Analysis の測定値、料金は API の100万トークンあたりの入力 / 出力(米ドル)。
この記事に出てきた用語・モデル
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事