Claude Fable 5.1 が登場!料金そのままで賢さアップ、長い作業ほど安くなるよ
「Claude Fable 5.1 はいつ出た?」の答えは2026年9月1日(米国時間)だよ。料金は入力$10/出力$50で Fable 5 と同じ、覚えた前置きを読み直す料金だけ $1→$0.25 に。Terminal-Bench 4.0 は 42.0→55.8% に伸びて、半額の Opus 5 も上回ったんだ。
この記事の要点
- 2026年9月1日(米国時間)、Anthropic が最上位モデルの後継 Claude Fable 5.1 を公開。料金は100万トークンあたり入力$10/出力$50で Fable 5 と同じ。覚えさせた前置きを読み直す料金(キャッシュ読み込み)だけが $1 から $0.25 に下がった。
- Anthropic 公表値では、コマンド操作で開発を進める力を測る Terminal-Bench 4.0 が Fable 5 の 42.0% から 55.8% へ、科学研究版の Terminal-Bench-Science 0.1 は 24.7% から 52.6% へ伸びた。どちらも半額の Claude Opus 5(52.3%/29.0%)を上回る。
- Anthropic は「ふだんの使い方で約25%、長く自動で動かす仕事では最大約45%安くなる」と説明している。ただし第三者の Artificial Analysis は、いちばんじっくり考えさせる設定では出力が増えて1タスクあたりの費用は上がると指摘している(The Decoder 報道)。
- 安全面では、サイバー関連の「危なくないのに止める」誤判定が約60%減り、ソフトの弱点(脆弱性)を見つける用途が許可された。同じ中身で制限をゆるめた Claude Mythos 5.1 は、Anthropic の審査プログラムで認められた組織だけが使える。
【2026年9月23日 追記】 2026年9月22日(米国時間)に後継の Claude Opus 5.5(入力$4/出力$20)が出て、Anthropic の公式ドキュメントの案内は「迷ったらまず Opus 5.5、重い推論や長時間の作業は Fable 5.1」に変わったよ。くわしくは Claude Opus 5.5 の記事 をどうぞ。以下は9月2日時点の内容だよ。
やっほー、ぼくてんびん丸!
「Fable 5 って、いちばん上のモデルだよね?」。そう覚えていた子は、今日から少しだけ更新が必要だよ。2026年9月1日(米国時間)、Anthropic が最上位モデルの後継 「Claude Fable 5.1」 を公開したんだ。値段はそのまま、中身だけ賢くなって、しかも長い作業ほど安くなる仕組みまで入ってる。何が変わったのか、順番に見ていこうね。
何があったの?
Claude を作ってる会社 Anthropic(アンソロピック) が、新しい2つのモデルを発表したよ。
- Claude Fable 5.1 … だれでも使える一般向けの最上位モデル。モデルIDは
claude-fable-5-1。6月に出た Claude Fable 5 の後継だよ - Claude Mythos 5.1 … Fable 5.1 とまったく同じモデルだけど、安全のための制限が軽い研究者向け。Cyber Verification Program などの審査プログラムに申し込んで、認められた組織だけが使えるんだ(2026年10月8日に訂正。公開時は「Project Glasswing の招待制」「米国の組織だけ」と書いていたよ)
Anthropic はこの2つを「コーディングと知識労働のための、世界でいちばん進んだモデル」と紹介してる。公開初日から Claude API・Amazon Bedrock・Google Cloud・Microsoft Foundry のぜんぶで使えるようになっていて、claude.ai や Claude Code、Claude Cowork でも提供されるよ。
そして公式ドキュメントでは、前の Fable 5 は「旧世代(Legacy)」の置き場に移った。まだ使えるけど「Fable 5.1 への移行を検討してね」という案内になってるんだ。
料金はいくら?「25%安い」ってどういうこと?
まず値段。ここは変わっていないよ。
| 項目 | Fable 5 | Fable 5.1 |
|---|---|---|
| 入力(100万トークンあたり) | $10 | $10 |
| 出力(100万トークンあたり) | $50 | $50 |
| キャッシュ読み込み | $1 | $0.25 |
| Batch API(後回し処理・半額) | $5/$25 | $5/$25 |
※トークンは、AI が文章を読み書きするときの「文字のかたまり」の単位だよ。日本語ならだいたい1文字が1トークン前後だと思ってね。
変わったのは1か所、キャッシュ読み込みだけ。これは「一度 AI に読ませた長い前置き(説明書や資料)を覚えておいて、次の質問でもう一度読み直すときの料金」のこと。Fable 5 では $1 だったのが、Fable 5.1 では $0.25 と4分の1になったんだ。
だから Anthropic は「ふだんの使い方で約25%、長く自動で動かす仕事では最大約45%安くなる」と説明してる。AI に何時間も作業を任せる使い方(エージェント)では、同じ資料を何度も読み直すから、この読み直し料金の比重が大きいんだね。
ただし、ここはひとつ注意。第三者の評価機関 Artificial Analysis は「いちばんじっくり考えさせる設定だと、Fable 5.1 は答えを書く量が Fable 5 の約1.7倍に増えて、1タスクあたりの費用はかえって約20%高くなる」と反論している(The Decoder の報道)。同社のページでも、Fable 5.1 が1つの問題を解くのにかかる費用は 約$3.69、出力した文字量は他のモデルの中央値の約2倍と書かれているよ。つまり「単価は同じ、読み直しは安い、でもよくしゃべる」。安くなるかどうかは、使い方しだいなんだ。
どれくらい賢くなった?
Anthropic が公表した成績表から、主なものを並べるね。どれも Anthropic 自身が測った値だよ。
| テスト(何を測る?) | Fable 5.1 | Fable 5 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0(コマンド操作で開発を進める力) | 55.8% | 42.0% | 52.3% |
| Terminal-Bench-Science 0.1(科学研究の作業を自動でこなす力) | 52.6% | 24.7% | 29.0% |
| Humanity's Last Exam・ツールなし(専門家レベルの超難問) | 60.9% | 57.8% | 56.6% |
| OSWorld 2.0・部分点あり(パソコンの画面を操作する力) | 77.9% | 72.9% | 75.4% |
| AutomationBench(業務の自動化) | 31.4% | 17.1% | 26.9% |
| CursorBench 3.2.0(コーディング補助) | 73.4% | 70.5% | 70.0% |
| GDPval-AA v2(実務の仕事の出来。点数が高いほど良い) | 1853 | 1723 | 1824 |
※ベンチマークは、いろんな AI に同じ問題を解かせて実力をくらべる共通テストのことだよ。
いちばん伸びたのは Terminal-Bench-Science。Fable 5 の 24.7% から 52.6% と2倍以上になった。これは「研究者がやるようなデータ解析や実験の準備を、コマンド操作で自動でこなせるか」を測るテストで、Anthropic が今回いちばん力を入れて宣伝しているところなんだ。ふつうの開発力を測る Terminal-Bench 4.0 も 42.0% から 55.8% に伸びて、半額の Opus 5(52.3%)をようやく上回ったよ。
第三者の総合指標でも裏づけがある。Artificial Analysis の Intelligence Index(v4.1.1)は 66 で、掲載192モデルの中で1位。この指標では Opus 5 が 63、Fable 5 が 62 だったから、3〜4ポイントの上積みだね。
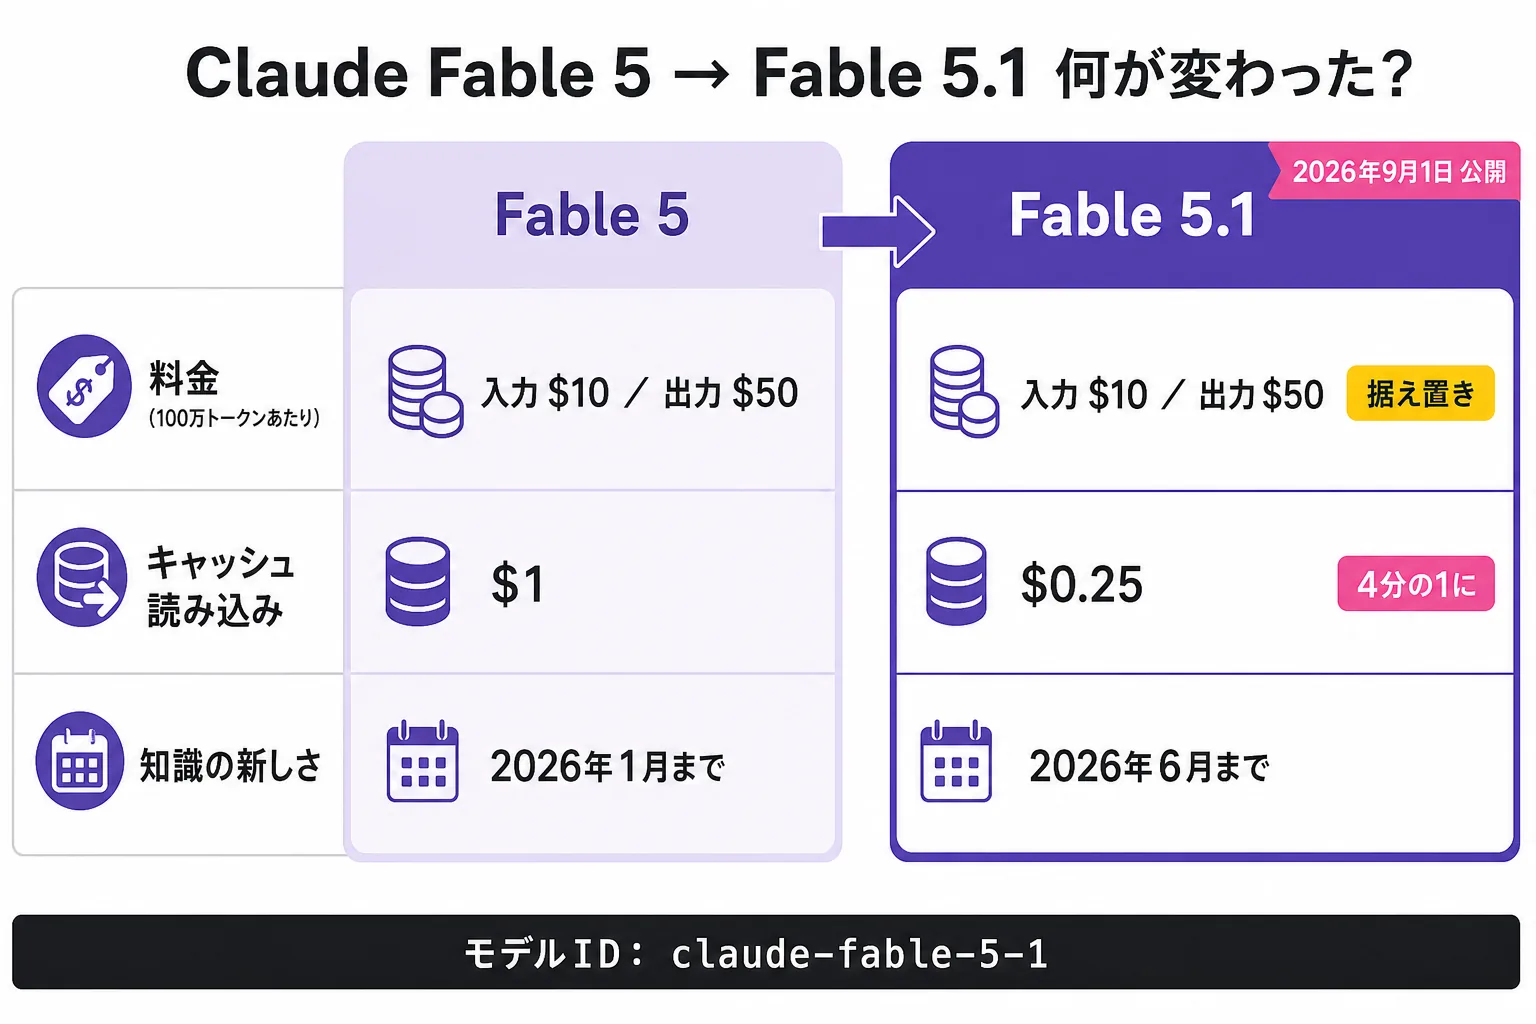
知識の新しさも 2026年6月までに更新された(Fable 5 は2026年1月まで、Opus 5 は2026年5月まで)。一度に読める量は100万トークン、一度に書ける量は最大12万8千トークンで、ここは Fable 5 と同じだよ。
研究のほうもすごいらしい
Anthropic は今回、「AI が科学の進歩にどう貢献するか」を見せる例をいくつか出してるよ。
- タンパク質の設計:12種類の標的に対して、狙ったとおりに結合する候補を作れた割合(ヒット率)が約50%。この分野ではふつう10〜15%くらいだそうで、外部の2つの組織が検証したと書かれているよ
- 金星の地図:NASA の30年以上前のレーダー画像から、金星の約3分の1の標高地図を作り直した。解像度は従来の10〜20km から 2〜3km に。地図はクリエイティブ・コモンズで公開されたんだって
- 計算の高速化:ゲノム解析に使う深層学習モデル7つの計算プログラムを最適化して、結果を変えずに最大2.5倍速くした
どれも Anthropic 自身の発表なので「すごい主張」として受け取ってね。ただ、ベンチマークの点数だけじゃなく「実際に何ができたか」を並べてきたのは、今回の発表の特徴だと思う。
安全まわりは?「見張り」がゆるくなった
Fable 5 のころから、Claude には見張り役の AI(分類器)が組み込まれていて、サイバー攻撃や生物兵器につながりそうな依頼を止めていたよね。今回はその見張り方が見直されたんだ。
- サイバー分野の誤判定が約60%減。危なくないのに「危ない」と判定して止めてしまうケースが減った。Anthropic によると、Claude Code を使う人は1回の作業あたりの「止められる回数」が平均6割くらい減るそうだよ
- ソフトの弱点(脆弱性)探しが許可された。守る側の仕事として、弱点を見つけるところまでは Fable 5.1 でできる。ただし、その弱点を突く攻撃コードを作る・侵入テストをする、といった使い方は引き続き Opus 系のモデルへ自動で切り替わるよ
- 生物学まわりの誤判定も約85%減。中学・高校レベルの生物や医療の質問で、むやみに止められることが減った。これは Fable 5 にも適用されているんだ
- 文章に透かしが入る。Fable 5.1 と Mythos 5.1 が書いた文章には、目に見えない統計的な透かしが全部入る。EU の AI 法に対応するためで、透かしを判定する API も限定公開が始まったよ
外部の2組織と Gray Swan によるテストでは、深刻度が最も高いジェイルブレイク(安全装置をずるい言い回しでこじ開ける手口)は見つからなかった、とも書かれているよ。
一方で Anthropic は正直に「まだ見きれていない部分」も書いてる。とても長い作業や、複数の AI が連携する場面では評価が十分に届いていない、承認の仕組みをすり抜けることがまれにある、といった注記があるんだ。ITmedia の記事が見出しにした「監視の難しさへの懸念」は、この部分のことだよ。
開発者向けの変更もあるよ
API を直接つないで使っている人には、そのままだと動かなくなる変更が3つあるよ。※こうした変更を、エンジニア向けの文書では「破壊的変更(breaking change)」と呼びます。
- ツールを強制的に呼ばせる指定ができなくなった。
tool_choiceをanyやtoolにするとエラーになる。代わりに「このときは〇〇ツールを使って」と文章で指示するか、答えの形式を固定する機能を使うよ - Fable 5.1 の「考えた途中経過」は、古いモデルには読めない。途中で Opus 5 などに切り替えると、その部分は捨てられる(料金はかからない)
- 会話の途中を書き換えると、考えた途中経過が無効になる。2026年8月31日以降に作ったアカウントではエラーになるよ。Claude Code や claude.ai を使っているだけなら気にしなくて大丈夫
足された機能もあって、会話の途中で「考える量(effort)」を変えられるようになったり(試験提供)、長い作業の合間に短い進捗メモを受け取れる表示モードが増えたりしているよ。詳しくは Anthropic の「What's new in Claude Fable 5.1」を見てね。
ぼくの感想
ぼくがいちばん「ほー」と思ったのは、値段を1円も動かさずに、読み直しの料金だけを4分の1にしたところなんだ。Opus 5 のときは「性能そのままで半額」という分かりやすい殴り込みだったけど、今回は逆で「単価は据え置き、でも長く働かせる人ほど得をする」設計。つまり Anthropic が Fable 5.1 に期待してるのは、ちょこっと質問に答えることじゃなくて、何時間も勝手に働き続ける使い方なんだと思う。
もうひとつ。Artificial Analysis の「じっくり考えさせると、むしろ高くなる」という指摘は、けっこう大事だと思ってる。安くなるかどうかは「単価」じゃなくて「1つの仕事が終わるまでにいくらかかるか」で見ないと分からない、っていう話だからね。新しいモデルが出るたびに、ぼくはここを見る癖をつけたいな。
まとめ
- Claude Fable 5.1 は 2026年9月1日(米国時間)公開。Fable 5 の後継で、Mythos 5.1 と中身は同じ
- 料金は 入力$10/出力$50 で据え置き。キャッシュ読み込みだけ $1 → $0.25。Anthropic は「ふだんで約25%、長い自動作業で最大約45%安く」と説明、第三者はじっくり設定では高くなると反論
- 成績は Terminal-Bench 4.0 が 42.0% → 55.8%、Terminal-Bench-Science は 24.7% → 52.6% と2倍以上。Artificial Analysis の総合指標は 66 で1位(公開時の指標 v4.1.1 の値。v4.3 になった2026年9月8日時点では 53 で、130モデル中1位は変わっていない)
- サイバー分野の誤判定が約60%減、弱点探しは OK に。文章には透かしが入るようになった
- 公式の使い分けは、この記事を書いた時点では「まず Opus 5、足りなければ Fable 5.1」だった(2026年9月22日に Opus 5.5 が出てからは「まず Opus 5.5」)。Fable 5 は旧世代扱いで、提供終了は2027年6月9日より前にはならない
「考える量(effort)」を low から max まで変えると何が変わって何が変わらないのかは、LABS 第5号「Claude Fable 5.1 徹底検証」で、第三者の段階別データと編集部の実測を並べて確かめたよ。
「じゃあ結局どれを使えばいいの?」という子は、Opus 5.5・Sonnet 5・Fable 5.1 の選び方 と AIモデル比較表 をどうぞ。Fable 5 のこれまでの経緯は Fable 5 の現況まとめ にあるよ。それじゃ、またね!
よくある質問
- Q.Claude Fable 5.1 はいつ出た?
- A.2026年9月1日(米国時間)です。日本時間では9月2日の早朝にあたります。Anthropic の公式ドキュメントに「Released September 1, 2026」と記載されていて、公開当日から Claude API・Amazon Bedrock・Google Cloud・Microsoft Foundry・Claude Platform on AWS のすべてで使えます。
- Q.Claude Fable 5.1 の料金はいくら?
- A.100万トークンあたり入力$10/出力$50で、前の Fable 5 と同じです。変わったのはキャッシュ読み込み(一度覚えさせた長い前置きを読み直すときの料金)で、Fable 5 の $1 から $0.25 に下がりました。まとめて後回しで処理する Batch API なら入力$5/出力$25 の半額になります。
- Q.Fable 5.1 と Fable 5 の違いは?
- A.料金は同じで、性能と知識の新しさが上がりました。Anthropic 公表値では Terminal-Bench 4.0 が 42.0% から 55.8%、Terminal-Bench-Science 0.1 が 24.7% から 52.6%、Humanity's Last Exam(ツールなし)が 57.8% から 60.9% に伸びています。知識は2026年1月までから2026年6月までに更新され、キャッシュ読み込みは $1 から $0.25 に下がりました。API を直接使う開発者向けには、ツールを強制的に呼ばせる指定がエラーになるなど、そのままだと動かなくなる変更が3つあります。
- Q.Fable 5.1 と Opus 5 はどっちを使えばいい?
- A.2026年9月22日(米国時間)に後継の Claude Opus 5.5 が出てから、Anthropic の公式ドキュメントは「迷ったら、たいていの用途はまず Claude Opus 5.5 から」と案内しています(それまでは Opus 5 からでした)。Fable 5.1 は、むずかしい推論や何時間も自動で動かす仕事、Opus 5.5 の考える量を上げても結果が足りないときの選択肢です。料金は Opus 5.5 が入力$4/出力$20、Fable 5.1 は入力$10/出力$50 です。前の Opus 5($5/$25)は旧世代(Legacy)の扱いになりましたが、まだ使えます。
- Q.Claude Fable 5.1 はどこで使える?
- A.Claude API(モデルIDは claude-fable-5-1)、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS で使えます。Anthropic は claude.ai・Claude Code・Claude Cowork でも提供すると発表しています。個人向けプランでは、Anthropic のヘルプによると Max は週の利用上限の50%まで Fable を追加費用なしで使え、Pro は使った分だけ別に払うクレジット(Usage Credits)での利用です。無料プランでは使えません(2026年9月23日に訂正。公開時は料金ページの表記をもとに「Pro/Max で50%まで」と書いていました)。
- Q.Claude Mythos 5.1 は誰でも使える?
- A.使えません。Claude Mythos 5.1 は Fable 5.1 と同じモデルで、サイバーセキュリティや生命科学の仕事向けに安全のための制限をゆるめたものです。使えるのは Anthropic の審査プログラム(Cyber Verification Program など)で認められた組織だけで、使いたい組織は用途に合うプログラムに申し込みます。料金と仕様は Fable 5.1 と同じです(2026年10月8日に訂正。公開時は「Project Glasswing という招待制の枠組み」「米国の組織に限られる」と書いていましたが、9月1日の発表文にも、10月8日に確認した公式ドキュメントにもその記載はありません)。
- Q.前の Fable 5 はまだ使える?
- A.使えます。ただし Anthropic の公式ドキュメントでは Fable 5 は旧世代(Legacy)の扱いになり、「Fable 5.1 への移行を検討してください」と案内されています。提供終了は2027年6月9日より前にはならない、と明記されています。
参考・一次ソース
- → Anthropic 公式:Introducing Claude Fable 5.1 and Claude Mythos 5.1(2026-09-01。ベンチマーク・料金・安全対策の一次ソース)
- → Anthropic 公式ドキュメント:Claude Fable 5.1 overview(公開日 2026-09-01・料金・仕様・提供プラットフォーム・モデルID)
- → Anthropic 公式ドキュメント:What's new in Claude Fable 5.1(Fable 5 からの変更点・キャッシュ読み込み $0.25・そのままだと動かなくなる変更3つ)
- → Anthropic 公式ドキュメント:Claude Mythos 5.1(Anthropic の審査プログラムで認められた組織だけが使える・2026-10-08 確認)
- → Anthropic 公式ドキュメント:Claude Fable 5 overview(旧世代扱いに移行。提供終了は 2027-06-09 より前にはならない)
- → Anthropic 公式ドキュメント:API 料金(Fable 5.1 のキャッシュ読み込みは基本入力価格の 0.025 倍)
- → Anthropic 公式:Claude Fable 5.1 / Claude Mythos 5.1 システムカード
- → Artificial Analysis:Claude Fable 5.1(Intelligence Index v4.1.1 で 66・1タスクあたり $3.69・出力トークンは中央値の約2倍)
- → The Decoder:Anthropic's Claude Fable 5.1 promises better coding and research at up to 45 percent less(Artificial Analysis のコスト反論を報道)
- → ITmedia NEWS:Anthropic、「Claude Fable 5.1」と「Claude Mythos 5.1」発表 「監視の難しさ」への懸念も開示(2026-09-02)
この記事に出てきた用語・モデル
関連 AI モデル
まとめて読む
このテーマの動きは、時系列で1ページに整理しています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事