
技術
Mixture of Experts(MoE)とは?
最終更新 (公開 2026年7月6日)
別名: MoE / 専門家混合
巨大モデルを「専門家チーム」に分けて軽くする手法。
⚡ 30秒でわかる
Mixture of Experts(MoE) の主なポイント
- 1 Mixture of Experts(MoE)は、複数の小さな専門家モデルを用意し、入力ごとに使う専門家だけを切り替えて動かすAIの設計手法です。
- 2 「ルーター」が質問に応じて関連する専門家を数個だけ起動するため、モデル全体は巨大でも1回の処理は軽く、推論が速く安くなります。
- 3 毎回すべてを使う通常の密(Dense)モデルと違い、MoEは総パラメータ数と実際に使うアクティブパラメータ数が分かれているのが特徴です。
- 4 現行の代表例は DeepSeek V4.1-Flash(総5520億。1トークンあたり動くのは読み込み時約80億・書き出し時約160億で、共有の専門家1人+担当わけされた専門家384人のうち6人だけが働く)。1つ前の世代は DeepSeek V4-Pro(総約1.6兆・アクティブ約490億)で、初期の代表例としては Mistral の Mixtral 8x7B(総約467億・アクティブ約130億)や DeepSeek V3(総6710億・アクティブ約370億)が知られています。
- 5 起源は Google 研究者らによる2017年の論文で、近年の大規模言語モデルを安価に賢くする中核技術として再評価されています。
📖 詳しく
Mixture of Experts(MoE) とは
Mixture of Experts(MoE、専門家混合)とは、1つの巨大なAIモデルで全てを処理するのではなく、役割の違う複数の小さな「専門家(エキスパート)」を用意し、入力に応じて使う専門家だけを切り替えて動かす仕組みのことです。入り口にいる「ルーター」と呼ばれる振り分け役が、質問ごとに最適な専門家を2〜数個だけ選んで起動し、残りは眠らせておきます。これが重要なのは、モデル全体は超巨大なのに、1回の処理で実際に動く部分はごく一部で済むため、賢さを保ったまま推論を速く・安くできるからです。たとえるなら、総合病院に大勢の専門医がいても、患者ごとに関係する数人の医師だけが診察し、全員が毎回出てくるわけではないイメージです。一般的なモデル(密/Denseモデル)が毎回すべてのパラメータを使うのに対し、MoEは「全パラメータ(総数)」と「実際に使うパラメータ(アクティブ数)」が分かれているのが最大の違いで、たとえば DeepSeek V3 は、総パラメータ6710億のうち1回の処理では約370億だけを使う構成になっています。
❓ FAQ
よくある質問
- Q. Mixture of Experts(MoE)とは何ですか?
- A. 1つの巨大モデルですべてを処理するのではなく、専門分野の異なる複数の小さな「専門家」を用意し、入力ごとに使う専門家だけを切り替えて動かす仕組みです。入り口の「ルーター」が質問に合った専門家を数個だけ選んで起動するため、モデル全体は巨大でも実際に動く部分は少なく、賢さを保ちながら推論を速く・安くできます。
- Q. MoEと普通の(Dense)モデルの違いは何ですか?
- A. 普通の密(Dense)モデルは、どんな入力でも毎回すべてのパラメータを使って計算します。一方MoEは「総パラメータ数」と「1回の処理で実際に使うアクティブパラメータ数」が分かれており、必要な専門家だけを動かします。そのため、同じ計算コストでもMoEの方がはるかに大きな知識量(総パラメータ)を持てるのが本質的な違いです。
- Q. MoEを採用している有名なモデルはありますか?
- A. いま動いているものでは DeepSeek V4.1-Flash(総5520億パラメータのうち、1トークンあたり読み込み時に約80億・書き出し時に約160億を使用)が代表例です。1つ前の世代の DeepSeek V4-Pro は総約1.6兆のうち1回に約490億を使っていました。初期のものでは Mistral の Mixtral 8x7B(総約467億のうち約130億を使用)や DeepSeek V3(総6710億のうち約370億を使用)が知られています。GPT-4 もMoE構造だと広く報じられていますが、OpenAI からの公式な確認はありません。
- Q. 初心者がMoEモデルを使うときに注意することは?
- A. 使う側の操作は通常のチャットAIと変わらないので、特別な設定は要りません。ただしモデルのスペックを見るときは、「総パラメータ数」だけで賢さや動作の重さを判断しないことが大切です。実際の処理速度やコストに効くのは1回あたりのアクティブパラメータ数なので、両方の数字を分けて見る習慣をつけると理解が深まります。
🔗 関連
あわせて読みたい
関連用語
関連 AI モデル
📰 この用語が登場する記事
「Mixture of Experts(MoE)」が出てくるニュース
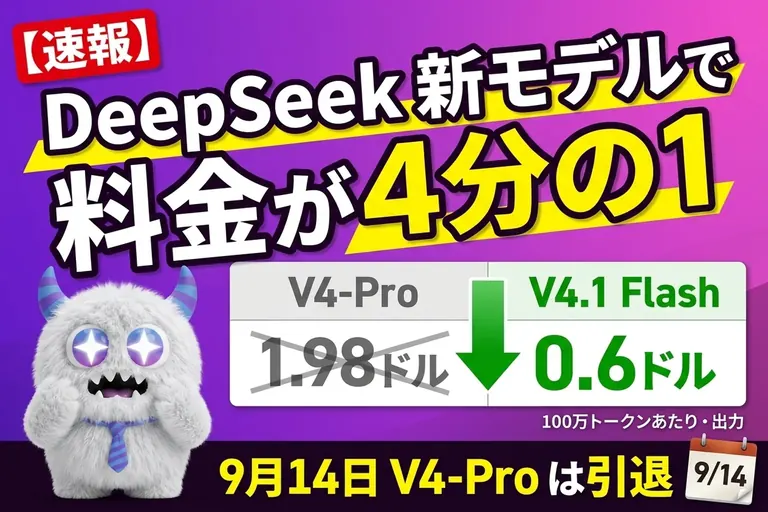
2026/9/11
DeepSeek V4.1 Flash とは?料金は4分の1、V4-Pro の引退は撤回
2026/8/28
GLM-5.3-Flash とは?ox-alpha の正体、商用OKで1タスク$0.24
2026/8/20
国産オープンLLM「LLM-jp-4 33B」公開!商用可・必要容量66GB・性能はどこまで
2026/7/20
Alibaba「Qwen3.8-Max」が8月3日に正式リリース!総2.4兆パラメータ、Terminal-Bench 2.1 は86.6で Fable 5 超え・SWE-bench Pro は67.7で届かず
2026/7/6
Kimi K3 とは?2.8兆パラメータの世界最大級オープンモデル、重み公開【2026年10月】
2026/7/6
「Qwen 4」はまだ出てない【2026年10月時点】主力は Qwen3.8-Max・いつ出る?
📎 SOURCES
一次ソース
- → Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer (Shazeer et al., 2017)
- → DeepSeek-V3 Technical Report (arXiv)
- → Hugging Face: deepseek-ai/DeepSeek-V4.1-Flash(総5520億・専門家384人中6人が働く・2026-09-11 確認)
- → Hugging Face: deepseek-ai/DeepSeek-V4-Pro-0813(1つ前の世代の総パラメータ数)
- → DeepSeek: V4 Preview 発表(2026-04-24)