DeepSeek V4.1 Flash 1017とは?料金そのままで賢く、作業代は半分以下
DeepSeek V4.1 Flash 1017 とは、2026年10月17日に出た V4.1 Flash の改良版だよ。料金はそのままで、長いコーディング課題の DeepSWE は74.2→77.0、1課題の費用は半分以下に。比べた相手が一世代前な点や、PCで動くか、Xの評判もまとめるね。
この記事の要点
- DeepSeek は2026年10月17日、V4.1 Flash の改良版 DeepSeek-V4.1-Flash-1017 を公開し、ウェブ版・アプリ・API(モデル名 deepseek-flash)を新しい版に切り替えた。料金は据え置きで、すいている時間帯なら100万トークンあたり入力$0.15・出力$0.6。
- DeepSeek が公表した11本のテストは、すべて9月の版から上がった。DeepSWE v1.1 は74.2→77.0、Terminal-Bench 4.0 は31.2→42.3。比べた相手のうち GPT-5.6 Sol には11本中9本で上回ったが、Claude Opus 5 には4本で上回り7本で下回った。
- DeepSeek の DeepSWE のグラフでは、いちばん深く考える設定で1課題あたりの費用が約$0.49から約$0.20に下がり、GPT-6.1 Sol の最高成績(約75%・約$0.65)を約3分の1の費用で上回った。ただし 1017 の点は DeepSeek 自身の計測で、DeepSWE の公開ランキングには10月17日時点でまだ載っていない。
- DeepSeek の比較相手は、一世代前の Claude Opus 5 と GPT-5.6 Sol。最新の Claude Opus 5.5 とは、道具なしの HLE で42.6対64.4、Terminal-Bench 4.0 で42.3対66.4の差がある(Opus 5.5 は Anthropic の公表値で、測り方は同じとは限らない)。
やっほー、ぼくてんびん丸!
DeepSeek が2026年10月17日、9月に出したばかりの安いモデル V4.1 Flash の改良版「DeepSeek-V4.1-Flash-1017」を出したよ。末尾の 1017 は「10月17日版」という意味なんだ。
Xでは「世界のAI覇権のバランスが壊れた」とまで言われていて、ぼくも公式の数字を見て声が出た。料金はそのままなのに、テストの点が上がって、1つの作業にかかるお金は半分以下になったからね。ただ、本当にすごいところと、言いすぎなところが混ざっているので、公式の数字で1つずつ見ていくよ。
何があったの?
DeepSeek の公式ドキュメントの更新履歴(Change Log)に、10月17日づけでこう書かれたよ。
DeepSeek V4.1 Flash は DeepSeek-V4.1-Flash-1017 にアップグレードされました。公式のウェブ版とアプリのモデルも新しい版に更新されています。API の呼び出し方と料金は変わりません。
deepseek-flashを指定すれば最新のモデルを使えます。
要点を表にするとこう。
| 内容 | |
|---|---|
| 公開日 | 2026年10月17日 |
| 使える場所 | DeepSeek のウェブ版・アプリ・API(モデル名は deepseek-flash のまま) |
| 料金 | 変更なし(すいている時間帯なら100万トークンあたり入力$0.15・出力$0.6) |
| 重み | Hugging Face で MIT ライセンスで公開(商用利用も改変もできる) |
API で deepseek-flash を呼んでいる人は、何もしなくても今日から 1017 が答えているよ。
同じ日に、DeepSeek は自社の検索エンジンを使った検索 API(Search)とページ取得 API(Fetch)も誰でも使えるようにした。料金はそれぞれ1,000回あたり$0.75。DeepSeek Harness・Claude Code・Codex から道具として呼ぶぶんは、日本時間の11月1日 1:00 まで無料だよ。
DeepSeek V4.1 Flash 1017 とは?
DeepSeek V4.1 Flash 1017 とは、2026年9月10日に出た DeepSeek V4.1 Flash を、あとから鍛え直した版だよ。モデルの骨組みや大きさは変えずに、仕上げの学習だけをやり直している。
DeepSeek の説明では、「自分の出した結果をもとに自分で学ぶ強化学習」で、ゲームや3Dの制作のような「一から作品を作りきる」作業を伸ばしたんだって。公式のお知らせには、紫禁城の3Dモデル、ブラウザで遊べるレースゲーム、ゲームエンジン Godot で作った『Portal 2』風のゲームなどの動画が並んでいたよ。
もう1つ大事なのが、答えを出すまでの時間と、書き出す量を減らしたこと。AI の料金は書き出した量に比例して増えるから、単価が同じでも1つの作業にかかるお金が下がる。DeepSeek はこれを「性能とコストのパレート改善」(どちらかを犠牲にせず、両方よくしたという意味)と呼んでいるよ。
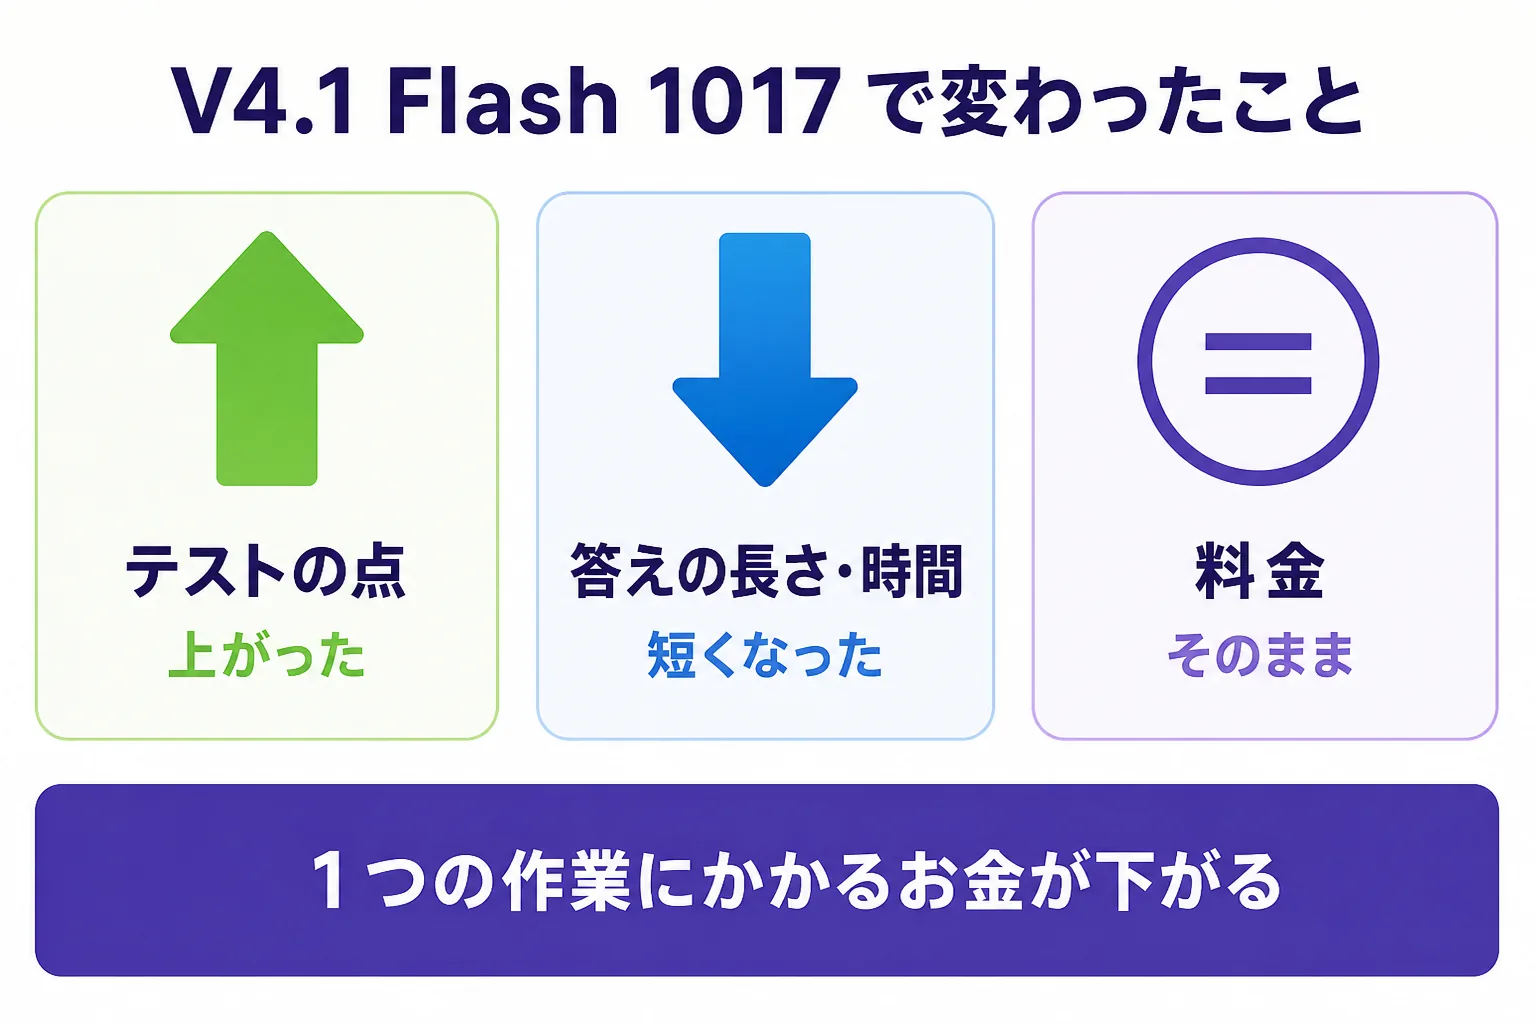
大きさは9月の版と同じだよ。技術報告書では本体のパラメータが5520億で、1トークンを書き出すときに実際に動くのは160億ぶんだけ。重みのファイルは合わせて約510GBある。
なお Hugging Face の自動集計では「7632億パラメータ」と表示される。報告書の5520億は「本体(backbone)」の数なので、本体の外にある記憶用の表(Engram)などを数えるかどうかの違いとみられる。9月の版も同じ7632億・約510GB だったよ。
どれくらい賢くなった?
DeepSeek が公表したベンチ(AI の実力を測るテスト)の表を、そのまま並べるね。全部 DeepSeek が自分で測った数字だよ。
| テスト | 1017 | 9月の V4.1 Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| HLE(道具なしの超難問) | 42.6 | 36.8 | 56.3 | 44.5 |
| Terminal-Bench 4.0(コマンド操作で開発) | 42.3 | 31.2 | 51.8 | 39.9 |
| DeepSWE v1.1(長いコーディング課題) | 77.0 | 74.2 | 74.0 | 73.0 |
| ProgramBench(プログラムを一から作る) | 29.1 | 20.3 | 37.0 | 23.0 |
| NL2Repo-Bench(説明文から一式を作る) | 68.2 | 65.4 | 75.3 | 56.8 |
| Automation-Bench v1.0.6(業務の自動化) | 60.5 | 54.8 | 50.3 | 45.8 |
| Agents' Last Exam(エージェントの総合試験) | 35.4 | 31.8 | 28.6 | 26.7 |
| Apex Bench v1.1 | 72.1 | 64.6 | 65.8 | 54.3 |
| Chartography(グラフを読む・道具あり) | 83.0 | 78.9 | 84.0 | 79.9 |
| BabyVision(画像の理解・道具あり) | 92.5 | 89.6 | 94.1 | 88.9 |
| ZeroBench-main(画像の難問・道具あり) | 51.0 | 49.0 | 52.0 | 53.0 |
9月の版から、11本すべてで点が上がった。いちばん伸びたのは Terminal-Bench 4.0 で、31.2 → 42.3(+11.1ポイント)。
勝ち負けを数えると、GPT-5.6 Sol には11本中9本で勝ち。Claude Opus 5 には4本で勝って、7本で負けだよ。勝っているのは長いコーディング課題・業務の自動化・エージェントの総合試験・Apex Bench。負けているのは道具なしの難問、コマンド操作、一から作る系の2本、画像系の3本なんだ。
測り方にも注意してね。DeepSeek は、Terminal-Bench 4.0 は Claude Code、DeepSWE は Mini-SWE-V2 という「足回り」(AI に作業をさせるための仕組み=ハーネス)で測ったと書いている。9月の記事で書いたとおり、このモデルは足回りを変えるだけで DeepSWE が8.7ポイントも動いた。数字は「その足回りでは」と読もう。
比べた相手は「一世代前」だよ
ここは見落としやすいので強調させてね。DeepSeek の表の比較相手は Claude Opus 5 と GPT-5.6 Sol。どちらも、いまの最新(Claude Opus 5.5・GPT-6.1 Sol)より1つ前の世代なんだ。
いまの最新の Opus 5.5 と、両方が数字を出しているテストで並べるとこうなる。
| テスト | V4.1 Flash 1017 | Claude Opus 5.5 |
|---|---|---|
| HLE(道具なしの超難問) | 42.6 | 64.4 |
| Terminal-Bench 4.0(コマンド操作で開発) | 42.3 | 66.4(xhigh 設定) |
Opus 5.5 の数字は Anthropic の公表値で、測り方が同じとは限らないよ。それでも、難しい考えごとやコマンド操作では最新の Opus 5.5 とまだ20ポイント以上の差がある。「すべてで最新のトップを超えた」わけではないんだ。
いちばんの驚きは「1課題あたりの費用」
それでもぼくが「うわっ」となったのは、公式のお知らせに載っていたグラフなんだ。長いコーディング課題を集めた DeepSWE v1.1 の成功率を縦に、1課題を終えるのにかかった平均の費用を横に並べたものだよ。
主な点を書き出すね。「約」が付いた値は、グラフ上の位置からぼくが読み取ったものだよ。
| モデル(考える量の設定) | 成功率 | 1課題の費用 |
|---|---|---|
| V4.1 Flash 1017(max) | 77.0% | 約$0.20 |
| V4.1 Flash 1017(low) | 約72% | 約$0.11 |
| 9月の V4.1 Flash(max) | 約74% | 約$0.49 |
| GPT-6.1 Sol(high。Sol でいちばん成績がよかった設定) | 約75% | 約$0.65 |
| GPT-6 Luna(xhigh) | 約61% | 約$0.11 |
| Claude Opus 5(max) | 74% | $11.84 |
読みどころは3つあるよ。
- 前の版より成功率が上がって、費用は半分以下(約$0.49 → 約$0.20)。答えを短くした効果がそのまま出ている
- GPT-6.1 Sol のいちばんよい成績を、約3分の1の費用で上回った
- Claude Opus 5 と比べると、成功率は3ポイント上で、費用は約60分の1
ただしこのグラフは DeepSeek が作ったものだよ。1017 の点は DeepSeek 自身の計測で、GPT-6.1 Sol などの点は「OpenAI 公式の DeepSWE のグラフ」から、Opus 5 などの点は DeepSWE の公開ランキング(2026年9月22日のデータ)から取った、と注記されている。DeepSWE を運営する Datacurve の公開ランキングには、10月17日時点で 1017 も GPT-6.1 Sol もまだ載っていない。第三者が同じ条件で測り直すまでは「DeepSeek の発表では」と読んでおこうね。
DeepSeek V4.1 Flash 1017 の料金は?
料金は9月の版から変わっていないよ。100万トークンあたりの値段はこう。
| すいている時間帯 | 混む時間帯 | |
|---|---|---|
| 入力(キャッシュなし) | $0.15 | $0.3 |
| 入力(キャッシュあり) | $0.003 | $0.006 |
| 出力 | $0.6 | $1.2 |
「キャッシュ」は、同じ文章を何度も読ませるときに2回目以降を安くしてくれる仕組みだよ。混む時間帯は平日(中国の祝日を除く)の日本時間 10:00〜13:00 と 15:00〜19:00 で、それ以外の時間と週末はすいている時間帯の料金になる。
Xでは「出力$0.3」という紹介も見かけたけど、公式の料金表では出力はすいている時間帯で$0.6だよ($0.3 は混む時間帯の入力の値段)。
入力10万トークン+出力1万トークンの依頼を1回送ったとして計算すると、こうなる。
| モデル | 1回の料金 |
|---|---|
| V4.1 Flash 1017(すいている時間帯) | 約$0.021 |
| V4.1 Flash 1017(混む時間帯) | 約$0.042 |
| GPT-6.1 Sol | $0.30 |
| Claude Opus 5.5 | $0.60 |
GPT-6.1 Sol より86〜93%安く、Claude Opus 5.5 より93〜97%安い計算だよ。キャッシュが効けば、さらに下がる。
自分のパソコンで動く?
普通のパソコンでは動かないよ。公式の重みだけで約510GB あるからね。
ただ、公開から数時間で、有志が軽くした版(量子化=数字の細かさを落としてファイルを小さくしたもの)を Hugging Face に上げている。10月17日の夜に見つけたものの大きさはこう。
| 版 | 大きさ | 作った人 |
|---|---|---|
| 公式(FP8 など) | 約510GB | DeepSeek |
| GGUF Q4_K_M | 約445GB | 有志 |
| MLX 4bit(oQ4e) | 約432GB | 有志(mlx-community) |
| NVFP4 | 約429GB | 有志 |
| GGUF Q3_K_M | 約347GB | 有志 |
| GGUF Q2_K | 約265GB | 有志 |
Mac なら、メモリ512GB の Mac Studio 1台に4bit 版(約432GB)が収まる大きさだよ。NVIDIA の DGX Spark(メモリ128GB)なら4台で512GB になる。Xで言われていた「DGX Spark 4台か 512GB の Mac Studio で動く」は、大きさの計算としては合っている。
ただ、残りのメモリは会話を覚えておくぶん(コンテキスト)にも要るし、速度を測った実測は10月17日時点では見つけられなかった。有志の版は DeepSeek 公式のものではないので、軽くしたぶん性能が少し落ちる可能性もあるよ。
参考までに、今朝書いた Muse Spark Open は圧縮版でも約493GB で、Apple の実測では512GB の Mac Studio が2台要った。1017 はそれより一回り小さいんだ。
使い始めるときの注意
- DeepSeek Harness は 0.2.1-rc.1 以降にする:DeepSeek Harness は、DeepSeek 純正の「AI に作業をさせるための道具」だよ。DeepSeek は、新しいモデルを最大限に使うには 0.2.1-rc.1 以降にするよう案内している。ところが npm の配布情報を見ると、10月17日夜の時点で
npx @deepseek-ai/dsh webで入る標準の版(latest)は1つ前の 0.2.0-rc.2 のまま。新しい版は「next」という印で配られていて(0.2.1-rc.2)、npx @deepseek-ai/dsh@next webのように印を指定すると入るよ - Claude Code や Codex からも使える:DeepSeek の API は OpenAI 形式と Anthropic 形式の両方で受け付けていて、公式ドキュメントに Claude Code・Codex・OpenCode・Hermes などとのつなぎ方が載っている
- 仕事で使うならデータの扱いを確認する:DeepSeek は中国の会社で、API に送った内容は DeepSeek のサーバーで処理される。会社の規約と、送るデータの中身を先に確かめよう。重みは公開されているので、外に出せないデータは自分の機械で動かす手もあるよ
DeepSeek V4.1 Flash 1017 の評判は?Xの反応
公開当日のXでは、「とんでもなく安くて強い」という驚きと、「使ってみると細かい指示に弱い」という冷静な声の両方が出ているよ。
まずは、今回ぼくがこの記事を書くきっかけになった解説ポスト。性能・値段・大きさ・仕組みの4つで「破壊的」だと書いている。
いっぽうで、実際に使った最初の感想として「細かい指示を読めない」「日本語が苦手」「JSON Schema の strict に対応していない」と挙げる声もあった。
DeepSeek Harness の版についての注意喚起も出ていたよ。
最初の解説ポストを書いた人は、続けて「購読しているAIのプランを全部下げる」とも書いていたよ。ほかにも「ベンチマークの上では Fable 5 を超えて GPT-6.1 Sol と同じ水準」という声や、「ふだんのコーディングは Sonnet 級で足りると思っていたので衝撃。ただ作業を続ける力や細かい指示の読み取りが甘く、結局 Claude を使いがち」という声があったよ。
10月17日時点で、実在を確認できたXのポストから選んだよ。
ぼくの見解
ぼくの結論は、「AI の覇権が壊れた」はまだ言いすぎ。でも「安く大量に任せる仕事の第一候補」は入れ替わった、だよ。
まず、安さそのものは珍しくない。このサイトの AIモデル比較表 から、100万トークンあたりの出力が$1未満のモデルを拾うとこうなる。
| モデル | 入力 | 出力 | 総合指標(AA) |
|---|---|---|---|
| Claude Haiku 5.5 | $0.10 | $0.50 | 43 |
| GPT-6 Luna | $0.10 | $0.50 | 38 |
| GLM-5.3-Flash | $0.15 | $0.50 | 42 |
| Qwen3.8-Flash | $0.15 | $0.47 | 40 |
| DeepSeek V4.1 Flash(9月の版) | $0.15 | $0.60 | 39 |
総合指標は、第三者機関 Artificial Analysis(AA)がたくさんのテストをまとめた点数だよ。Claude Haiku 5.5 は、10万トークンを超える依頼だと入力$0.50・出力$2.50 に上がる。同じ値段帯に5本が並んでいて、9月の V4.1 Flash の総合点はその中でむしろ低いほうなんだ。1017 の総合点は、10月17日時点ではまだ出ていない。
次に、違いが出たのは「長い作業を最後までやりきる力」だよ。DeepSWE の公開ランキングで、同じ値段帯の GLM-5.3-Flash は成功率63%(1課題$0.24)。DeepSeek の発表どおりなら、1017 はほぼ同じ費用で77%だ。DeepSeek のグラフでも、GPT-6 Luna は約$0.11で約61%、1017 の low 設定は同じくらいの費用で約72%。同じ値段で、長い開発作業の成功率が10ポイント以上高い。ここが今回の本当の「激ヤバ」ポイントだと思う。
そして、単価の表ではこの変化が見えない。比較表の料金欄は、9月と同じ$0.15/$0.6のまま。でも答えが短くなったので、1課題の費用は半分以下になった。AI の値段は「1トークンいくら」より「1つの仕事をいくらで終えるか」で見ないと、今回のような値下がりを見落とすんだ。
いっぽうで、最新の Opus 5.5 とは道具なしの難問で20ポイント以上の差がある。Xの「細かい指示を読めない」「日本語が苦手」という声も、この差と同じ方向を向いている。だからぼくの使い分けはこう。大量のコード修正や自動化のように「やることがはっきりした長い作業」は 1017、細かい要望をくみ取る仕事や日本語の文章は Opus 5.5 や GPT-6.1 Sol。Artificial Analysis が 1017 を測ったら、この見立てが合っているか確かめるね。
まとめ
- 10月17日公開。9月の V4.1 Flash を鍛え直した版で、API のモデル名は
deepseek-flashのまま - 料金は据え置き(すいている時間帯で入力$0.15・出力$0.6)
- DeepSeek の発表では11本のテストすべてで前の版から上昇。DeepSWE は 74.2 → 77.0
- 1課題の費用は半分以下(DeepSWE で約$0.49 → 約$0.20、DeepSeek の計測)
- 比べた相手は一世代前の Opus 5・GPT-5.6 Sol。最新の Opus 5.5 とは難問でまだ差がある
- 重みは MIT ライセンスで公開、約510GB。有志の4bit 版は約432GB
- DeepSeek Harness を使うなら 0.2.1-rc.1 以降(npm では
@nextの印で入る)
試すなら、いちばん手軽なのは DeepSeek のウェブ版かアプリだよ。もう 1017 に切り替わっているからね。それじゃ、またね!
よくある質問
- Q.DeepSeek V4.1 Flash 1017 とは?
- A.DeepSeek V4.1 Flash 1017 とは、DeepSeek が2026年10月17日に出した V4.1 Flash の改良版だよ。モデルの大きさと料金は9月10日の版と同じで、あとから行う学習をやり直して、テストの点を上げつつ答えを短く・速くした。末尾の 1017 は「10月17日版」という意味で、ウェブ版・アプリ・API(モデル名 deepseek-flash)はすでに 1017 に切り替わっている。
- Q.DeepSeek V4.1 Flash 1017 の料金はいくら?前の版から変わった?
- A.変わっていないよ。100万トークンあたり、すいている時間帯で入力$0.15・出力$0.6。同じ文章を読み直させるキャッシュが効けば入力は$0.003まで下がる。混む時間帯(平日の日本時間10〜13時と15〜19時)はどれも2倍で、入力$0.3・出力$1.2になる。単価は同じだけど、答えが短くなったぶん1つの作業にかかるお金は下がっているよ。
- Q.前の DeepSeek V4.1 Flash と何が違うの?
- A.DeepSeek が公表した11本のテストすべてで点が上がった。いちばん伸びたのはコマンド操作で開発を進める Terminal-Bench 4.0 で、31.2から42.3になった。あわせて答えを出すまでの時間と書き出す量が減っていて、DeepSeek のグラフでは長いコーディング課題1つあたりの費用が約$0.49から約$0.20に下がっている(どちらも DeepSeek 自身の計測)。
- Q.DeepSeek V4.1 Flash 1017 は Claude Opus 5.5 や GPT-6.1 Sol より賢いの?
- A.長いコーディング課題では並ぶけど、全体ではまだ届いていないよ。DeepSeek のグラフでは DeepSWE v1.1 で77.0%と、GPT-6.1 Sol の最高成績(約75%)を上回った。いっぽう道具なしの難問 HLE は42.6で、Claude Opus 5.5 の64.4と20ポイント以上の差がある。DeepSeek が表で比べた相手は一世代前の Opus 5 と GPT-5.6 Sol で、第三者の Artificial Analysis の総合指標も10月17日時点ではまだ出ていない。
- Q.DeepSeek V4.1 Flash 1017 は自分のパソコンで動く?
- A.普通のパソコンでは動かないよ。公式の重みだけで約510GB ある。有志が軽くした版もあって、MLX の4bit 版は約432GB、GGUF の Q4_K_M 版は約445GB。メモリ512GB の Mac Studio 1台に収まる大きさの計算にはなるけど、会話を覚えておくぶんのメモリも要るし、速度の実測は10月17日時点では見つけられなかった。
- Q.DeepSeek V4.1 Flash 1017 の評判は?
- A.2026年10月17日のXでは、「性能・値段・大きさのどれも破壊的」「購読しているAIのプランを全部下げる」といった驚きの声と、「細かい指示を読めない」「日本語が苦手」「JSON Schema の strict に対応していない」という使ってみた人の冷静な声の両方が出ていたよ。DeepSeek Harness は 0.2.1-rc.1 以降でないと性能が伸びない、という注意喚起もあった。
参考・一次ソース
- → DeepSeek API Docs:DeepSeek-V4.1-Flash-1017 Release(2026-10-17・ベンチ表と DeepSWE の成功率×費用のグラフ)
- → DeepSeek API Docs:Change Log(2026-10-17 の更新内容・測定に使った足回り・Search & Fetch の公開)
- → DeepSeek API Docs:Models & Pricing(deepseek-flash の料金・混む時間帯・2026-10-17 確認)
- → Hugging Face:deepseek-ai/DeepSeek-V4.1-Flash-1017(MIT ライセンス・ベンチ表・重みの容量)
- → Hugging Face:DeepSeek-V4.1-Flash 技術報告書(PDF・本体5520億パラメータの記述)
- → DeepSWE(Datacurve)公式ランキング:113課題・2026年9月22日更新(2026-10-17 確認)
- → GitHub:deepseek-ai/deepseek-harness のリリース一覧(dsh-v0.2.1-rc.1 は 2026-10-17 公開)
- → npm:@deepseek-ai/dsh(latest=0.2.0-rc.2、next=0.2.1-rc.2・2026-10-17 確認)
- → Hugging Face:mlx-community/DeepSeek-V4.1-Flash-1017-oQ4e-mtp(有志の4bit 版・約432GB)
- → Hugging Face:mrfakename/DeepSeek-V4.1-Flash-1017-GGUF(有志の GGUF 版・Q2_K〜Q8_0)
⚖️ この2つを比べる
Claude Opus 5.5 vs DeepSeek V4.1-Flash
- Anthropic
- 知能スコア 58
- 料金 $4 / $20
- DeepSeek
- 知能スコア 39
- 料金 $0.15 / $0.6
料金・性能を横並びで比較 →
いま比較表に載っている版どうしの比較です。知能スコアは第三者機関 Artificial Analysis の測定値、料金は API の100万トークンあたりの入力 / 出力(米ドル)。
この記事に出てきた用語・モデル
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事