
NEWS (16)
ニュース
2026/8/20
国産オープンLLM「LLM-jp-4 33B」公開!商用可・必要容量66GB・性能はどこまで
「LLM-jp-4 33B は商用利用できる?」の答えは“できる(Apache 2.0)”だよ。NII が2026年8月18日に llm-jp-4-33b-base/thinking の2本を公開。332億パラメータの Dense 型、容量は BF16 で約66.4GB、日本語 MT-Bench は8.00だよ。
2026/8/15
Qwen3.8-27B のウェイト公開!Apache 2.0で商用可、性能と必要な容量
Qwen3.8-27B の重みは商用利用できる Apache 2.0 で公開されたよ。パラメータは約278億、画像と動画も読めて、一度に読める量は262,144トークン。容量は BF16 版が約51.7GB、FP8 版が約28.7GB。旗艦の Qwen3.8-Max とはライセンスが違うんだ。
2026/8/11
Meta「Muse Glimmer」公開!24GBのVRAMで動く296億パラメータのオープンモデル──必要スペック・入手先・性能を整理するよ
2026年8月10日、Meta が誰でもダウンロードできるAIモデル「Muse Glimmer」を公開したよ。パラメータは約296億で、ライセンスは制限のゆるい Apache 2.0。圧縮版なら24GBのVRAMで動いて、精度の落ちは平均1.0%。Meta が中身を公開するモデルを出すのは2025年4月の Llama 4 以来なんだ。必要なメモリ・入手先・ベンチマークの数字・Llama 4 との違いを、公式のモデルカードと発表資料で整理するよ。
2026/7/20
Hugging Faceが自律型AIのサイバー攻撃を受けた話
Hugging Face が自律型AIエージェントによるサイバー攻撃を受けたよ。防御にもAIを使ったのに、各社の最上位モデルは安全のための歯止めが働いて攻撃コードの解析を拒否。最終的に中身が公開された GLM 5.2 を自社サーバーで動かして対応したんだ。
2026/7/20
Alibaba「Qwen3.8-Max」が8月3日に正式リリース!総2.4兆パラメータ、Terminal-Bench 2.1 は86.6で Fable 5 超え・SWE-bench Pro は67.7で届かず
Alibaba の旗艦 Qwen3.8-Max が8月3日に正式リリースされたよ。Terminal-Bench 2.1 は86.6で Claude Fable 5(84.6)超え。でも SWE-bench Pro は67.7で Fable 5(80.0)に届かず、FrontierSWE も差があるんだ。
2026/7/6
Kimi K3 とは?2.8兆パラメータの世界最大級オープンモデル、重み公開【2026年10月】
Kimi K3 の重みはもう落とせる?答えは落とせるよ。Moonshot AI が2026年7月16日に公開し、7月27日にフルの重みも Hugging Face で配布を始めたんだ。総2.8兆パラメータ・専門家分業型(MoE)・100万トークンの世界最大級だよ。性能と価格も整理するね。
2026/7/6
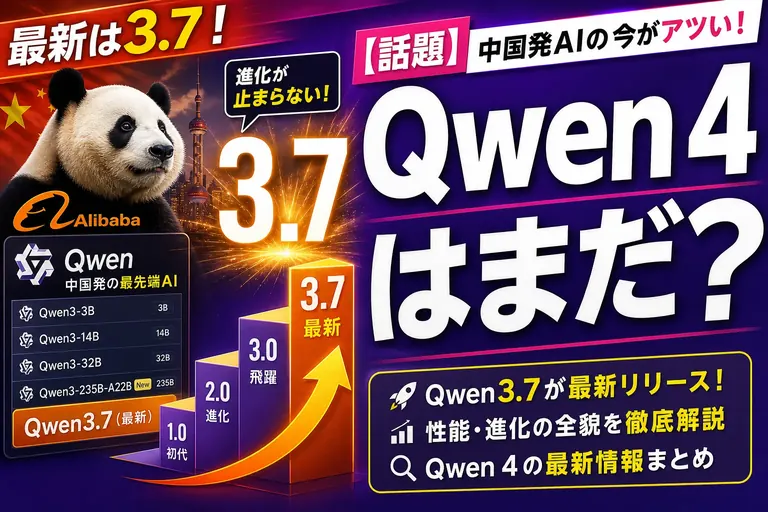
「Qwen 4」はまだ出てない【2026年10月時点】主力は Qwen3.8-Max・いつ出る?
「Qwen 4 はもう出た?」の答えは、2026年10月8日時点でも“まだ”だよ。Alibaba は9月22日に「Qwen 4 は学習中」と公式発表したけど、公開日・料金・性能はまだ出ていないんだ。いま使える旗艦は Qwen3.8-Max、その先の Qwen 5 は最大10兆パラメータの計画だよ。
2026/7/2
「DeepSeek V5 / R2」はまだ?【2026年10月時点】最新は V4.1-Flash
DeepSeek の次(V5 や R2)はもう出た?答えは2026年10月時点でも未発表だよ。いま使える最新は9月10日に公開された V4.1-Flash で、旧 V4-Flash は引退済み。予告されていた V4-Pro の引退は撤回されて、料金据え置きで継続提供になったよ。
2026/6/15
中国発『Kimi K2.7 Code』登場!1兆パラメータで持ち帰り自由
Moonshot AI がプログラミング特化の「Kimi K2.7 Code」を公開したよ。総1兆パラメータのMoE設計で文脈は256Kトークン。Kimi Code Bench v2 は50.9から62.0へ伸び、重みは Hugging Face で入手でき、API 料金は入力$0.95/出力$4だよ。
2026/6/11
Google『DiffusionGemma』が爆速!文章を一気に作る新方式
Google の「DiffusionGemma」は、画像生成でおなじみの拡散という仕組みを文章生成に使った新モデルだよ。260億パラメータのMoE設計(実際に動くのは38億)で、H100 なら毎秒1000トークン超、RTX 5090 でも毎秒700トークン超という速さなんだ。
2026/6/10
Cohereが開発者向け初モデル『North Mini Code』を無料公開
Cohere Labs が開発者向け初モデル「North Mini Code」を公開したよ。30Bパラメータのうち実際に動くのは3Bという省エネなMoE設計で、SWE-Bench Verified は80.2%、コンテキストは128K。Apache 2.0 で誰でもダウンロードできるんだ。
2026/6/7
小さいAIを4体組ませたら“裏社会の金融ゲーム”が動いたよ!『Build Small Hackathon』で分かった、小型モデルの賢い使い方なんだ
小さいAIを4体組ませたらどうなる?Hugging Face の Build Small Hackathon の開発レポートでは、嘘やインサイダー情報が飛び交う金融ゲームを作ったよ。0.5Bのファインチューン版が、自爆買い0%・有効な注文100%で3Bの先生モデルを上回ったんだ。
2026/6/5
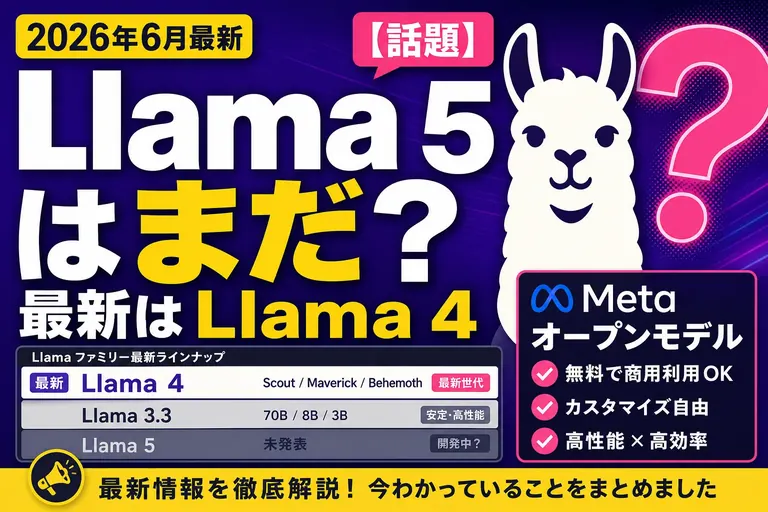
「Llama 5」はいつ出る?まだ未発表【2026年10月時点】最新は Llama 4
「Llama 5 はもう出た?」の答えは、2026年10月時点でも“まだ”。Llama ブランドの最新は Llama 4(Maverick / Scout、2025年4月)のまま。ただし2026年8月10日、Meta は Llama とは別シリーズのオープンモデル Muse Glimmer(約296億パラメータ・Apache 2.0)を公開して、重みを公開する路線に戻ってきたよ。バージョン履歴、ネットに出回る「Llama 5 リリース済み」という誤情報の正体、今オープンモデルを使うなら何を選ぶかを、てんびん丸が捏造ナシで整理するよ。
2026/5/23
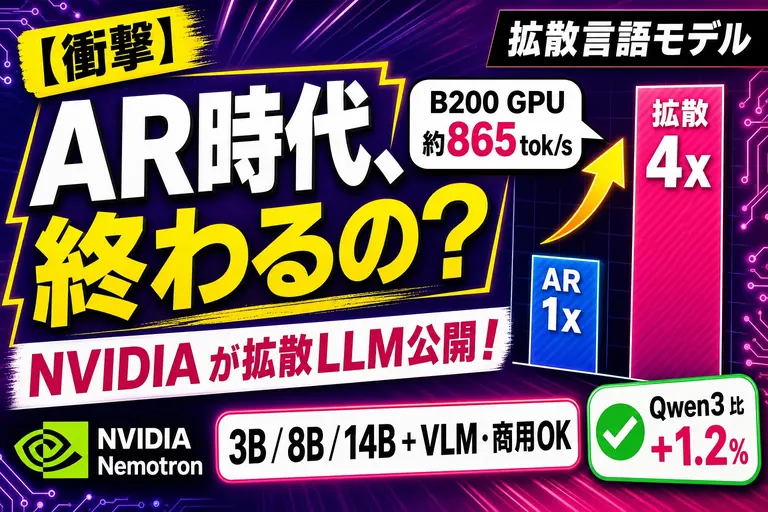
NVIDIA が『拡散言語モデル』Nemotron Diffusion を公開! 従来型(AR モデル)の約4倍速、文章をまとめて同時に書く新方式が来たよ
NVIDIA が拡散型の言語モデル「Nemotron-Labs Diffusion」を公開したよ。文章を1文字ずつではなく複数まとめて出してから磨き上げる方式で、B200 GPU で毎秒約865トークン、従来型の約4倍なんだ。3B・8B・14B の3サイズで商用利用もOKだよ。
2026/5/9
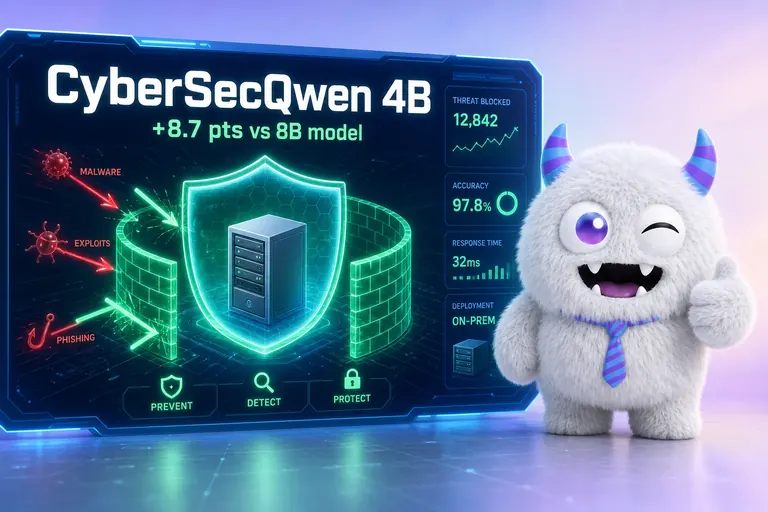
サイバー防衛AIは「小さくて専門特化」が正解?4BパラのCyberSecQwenが8Bモデルを食ったよ
AMD Developer Hackathon発の CyberSecQwen-4B が、サイバー攻撃の情報分析(脅威インテリジェンス)を測るテストで、倍サイズの Foundation-Sec-Instruct-8B を上回り。12GBのGPU1枚で動く、防衛特化のAI(LLM=文章を扱うAI本体)の中身を、てんびん丸が整理するよ。
2026/5/7
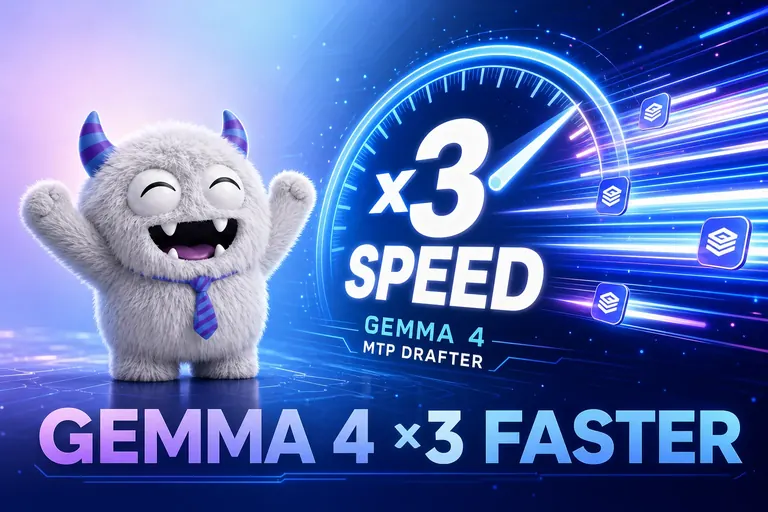
Google、Gemma 4 が一気に最大3倍速!『MTPドラフター』で推論ボトルネックを丸ごとぶち抜いてきたよ
Google が Gemma 4 向けの Multi-Token Prediction(MTP)ドラフターを公開。最大3倍の推論高速化を品質劣化ゼロで実現する新アーキテクチャを、てんびん丸が解説するよ。