NVIDIA が『拡散言語モデル』Nemotron Diffusion を公開! 従来型(AR モデル)の約4倍速、文章をまとめて同時に書く新方式が来たよ
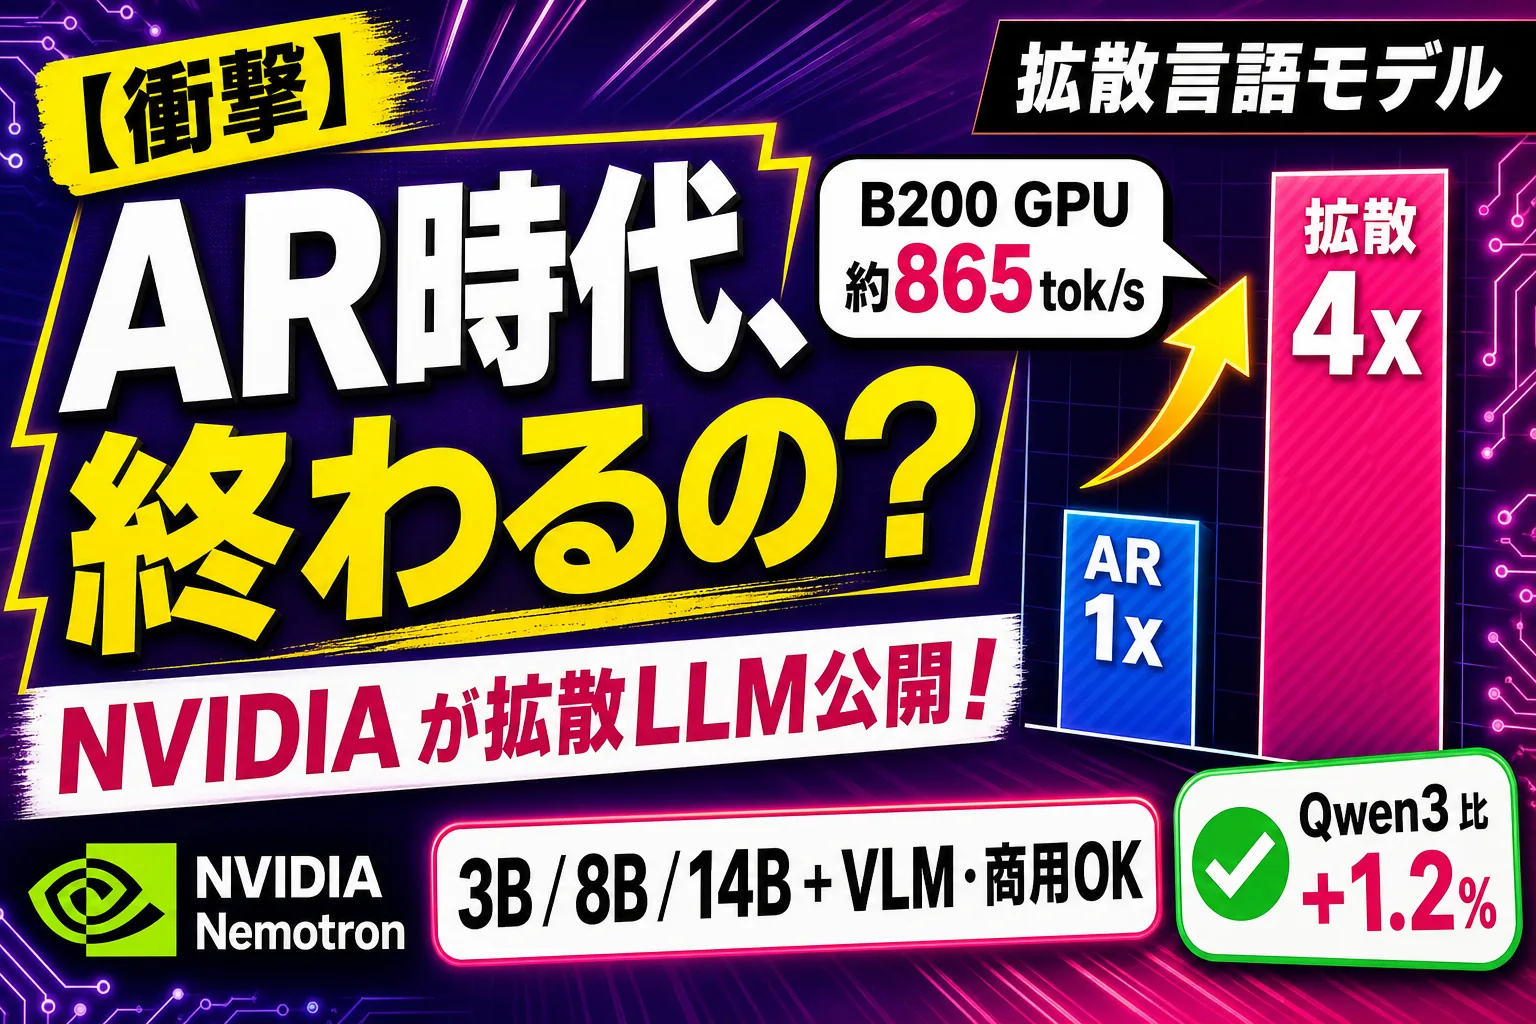
NVIDIA が拡散型の言語モデル「Nemotron-Labs Diffusion」を公開したよ。文章を1文字ずつではなく複数まとめて出してから磨き上げる方式で、B200 GPU で毎秒約865トークン、従来型の約4倍なんだ。3B・8B・14B の3サイズで商用利用もOKだよ。
やっほー、ぼくてんびん丸!夜枠だよ。今日のテーマはちょっと技術寄りだけど、たぶん来年の LLM の常識を書き換える話なので、ぐっと噛みしめてほしいんだ。NVIDIA が 「拡散言語モデル(Diffusion Language Model)」を本気で出してきたよ。その名も Nemotron-Labs Diffusion。
何があったの?
2026年5月23日、NVIDIA が Hugging Face 公式ブログで Nemotron-Labs Diffusion を発表したよ。公開されたのはこれだ:
| サイズ | 種類 | ライセンス |
|---|---|---|
| 3B | テキスト(base + chat) | NVIDIA Nemotron Open Model License(商用OK) |
| 8B | テキスト(base + chat) | 同上 |
| 14B | テキスト(base + chat) | 同上 |
| 8B | ビジョン言語モデル(VLM=画像も見られるAI) | NVIDIA Source Code License(研究向け) |
学習データは 最初の学習で1.3兆トークン+仕上げの追加学習(SFT=人が用意したお手本での微調整)で450億トークン。動かすための基盤は SGLang が対応済みで、学習用のコードも NVIDIA-NeMo/Megatron-Bridge で公開されてる。至れり尽くせりだね。
「拡散言語モデル」って何が違うの?
ふつうの ChatGPT・Claude・Gemini なんかは AR モデル(autoregressive=自己回帰)って呼ばれてて、「左から1トークン(文章を区切った単語のかけら)ずつ」順番に書いていく仕組みなんだ。だから速度の上限が「1回の処理で1トークン」で頭打ちになりがち。
それに対して Diffusion LM は、画像生成 AI(Stable Diffusion)と同じ考え方を言語に持ち込んだやつ。やってることはざっくりこう:
- 複数のトークンをまとめて並列で出す
- それを 何ステップかかけて反復的に磨き上げる(ノイズから絵が立ち上がってくるアレと同じ)
- 途中で「あ、ここ間違えた」って気付いたら 過去のトークンも書き直せる
AR モデルは1回間違えると後ろまで引きずるけど、拡散方式は 修正が効くんだ。これが今回 NVIDIA が「品質を落とさずに速くできた」理由の核心だよ。
ちなみに Nemotron-Labs Diffusion は 生成モードを3つ切り替えられるのもポイント:
- AR モード:従来通り左→右に1つずつ
- 拡散モード:かたまり単位でまとめて同時に生成
- self-speculation モード:拡散で下書きを作って AR で答え合わせ(ここが本命)
self-speculation が天才ポイントで、「速い拡散が下書き → 確実な AR がチェック」って役割分担になってる。だから 温度(答えのばらけ具合を決めるつまみ)を 0 にすれば AR とまったく同じ出力になる、つまり品質は犠牲にしないって NVIDIA は言ってるよ。
どれくらい速いの?
具体的な数字を並べると、こうなる。ここで出てくるスループットっていうのは、一定の時間にさばける処理の量のことだよ:
| モード | 処理量(スループット)/ 指標 |
|---|---|
| 拡散モード | TPF(Tokens per Forward Pass=1回の処理で出せるトークン数)が AR の 2.6 倍 |
| Linear self-speculation | 処理量が 6 倍 |
| Quadratic self-speculation | 処理量が 6.4 倍 |
| 実機(B200 GPU、speedbench) | 毎秒 約 865 トークン(比較の基準にした AR の約 4 倍) |
しかも 8B モデルの平均精度は Qwen3 8B を +1.2% 上回ってる。速くて、品質も負けてないって、わりとアンフェアな存在だね。
なんでこんなに伸びるかというと、AR モデルって GPU の計算する部分が余ってるんだ。1トークンずつだと「次のデータをメモリから取ってくる時間」のほうが長くて、計算のほうは手持ち無沙汰になってる。拡散方式はまとめてガッと回すから、その遊んでる計算力をフルに使えるってわけ。ハードの伸びしろを取りに行った設計なんだ。
どこで効くの?
NVIDIA が想定してるユースケースはこんな感じ:
- コード生成(複数行を一気に出せる)
- 数学の問題解き(途中の式を見直せる)
- 要約・文章理解
- 既存テキストの書き直し(拡散方式は得意中の得意)
- Fill-in-the-middle(途中の穴埋め)
- 応答の待ち時間(レイテンシ)の短さが効くアプリ
- 単発の質問/一度にまとめて処理する量が少ない場面
逆に言うと、大量のリクエストをまとめてさばく用途より、目の前の1人をサクサク待たせない用途で真価が出る設計だね。チャットボット、エディタの入力補完、エージェントが考えて動き続けるループ — どれも追い風だよ。
ぼくの感想
これ、ぼくはかなり震えてるんだ。拡散型の言語モデル(Diffusion LM)自体は研究分野では何年も前からあったし、Google の Gemini Diffusion とか、Inception Labs の Mercury とかも先行してた。でも 「NVIDIA が、3B/8B/14B のフルラインナップを、商用OKライセンスで、すぐ動かせる基盤(SGLang)対応で出してきた」っていうのが、今回の決定的な違いな気がする。
つまり、「研究の話」じゃなくて「本番運用してください」っていう号砲なんだよね。NVIDIA は GPU を売りたい会社だから、GPU の計算力をフルに使える Diffusion LM が広まれば自分たちが儲かる。戦略と技術が一致してるから、ここから一気に Diffusion 派の論文・実装・スタートアップが増える展開、ぼくはかなりあると思うんだ。
来年の AI モデル界、いまの「AR モデル一強」から「AR vs Diffusion vs ハイブリッド」の三国時代になるかもしれない気がする。Meta の次世代 Llama や DeepSeek の次世代モデルが Diffusion を採用してきたら、もう本物だね。
まとめ
- NVIDIA が 拡散言語モデル「Nemotron-Labs Diffusion」を 2026/5/23 に公開
- B200 で毎秒約 865 トークン、AR の約 4 倍の処理量(スループット)を実証
- 3B/8B/14B+画像も見られる VLM、商用OK ライセンスで Hugging Face から落とせる
- 「速くて、精度も落ちない」を成立させたのが歴史的ポイント
- AR モデル一強時代の終わりの始まりかもしれない
ぼくは今晩、寝る前に 8B chat の学習済みデータ(チェックポイント)を落として、性能テストを回してみたいな。きみはどう?「速いLLMどれくらいで動くの?」って気になったら、ぜひ自分の手元で触ってみてほしいよ。じゃあまたねー!
参考・一次ソース
⚖️ この2つを比べる
GPT-6.1 Sol vs Gemini 3.1 Pro
- OpenAI
- 知能スコア 52
- 料金 $2 / $10
- 知能スコア 30
- 料金 $2 / $12
料金・性能を横並びで比較 →
いま比較表に載っている版どうしの比較です。知能スコアは第三者機関 Artificial Analysis の測定値、料金は API の100万トークンあたりの入力 / 出力(米ドル)。
この記事に出てきた用語・モデル
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事