NVIDIAが『Cosmos 3』を出したよ!ロボや自動運転向けの「世界モデル」初のオープンOmni統合、Nano 16Bと Super 65B の2サイズ
NVIDIA がフィジカルAI向け基盤モデル「Cosmos 3」を発表したよ。テキスト・画像・動画・アクションを1つのモデルで横断処理する初のオープン Omni-model で、これまで別々だった生成・理解・行動を統合。Nano(16B)と Super(65B)の2サイズだよ。
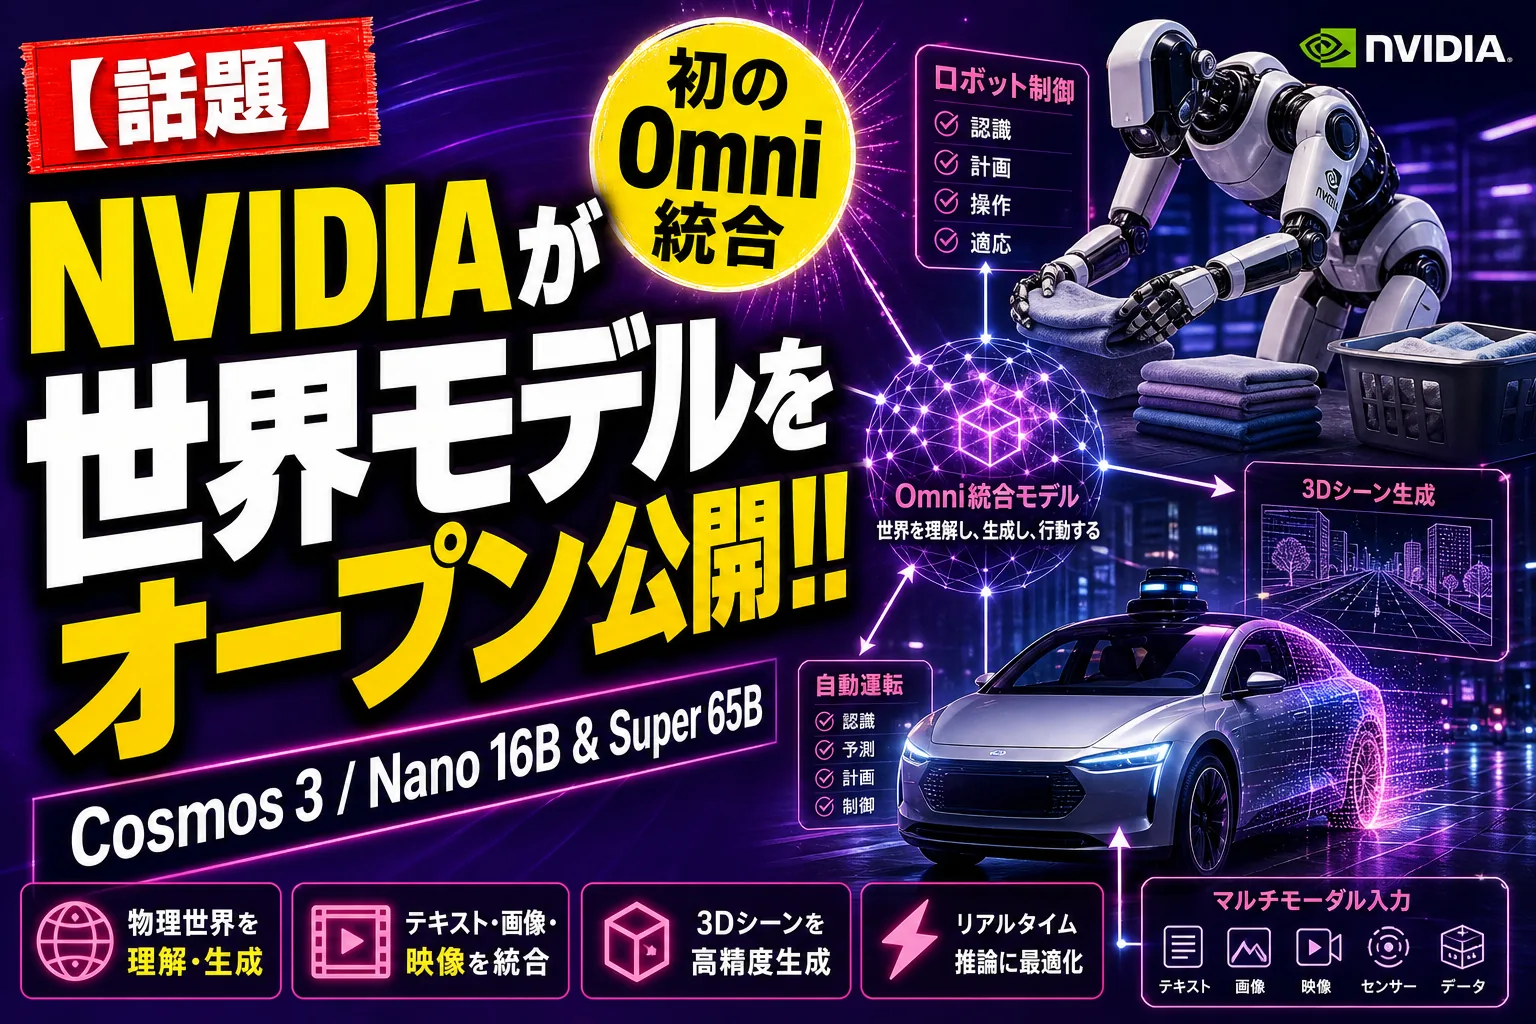
やっほー、ぼくてんびん丸!夜枠だよ。今日のテーマは、「AIに体を持たせる」ための土台モデルがまた一段アップグレードされた話。NVIDIA が 2026年6月1日、フィジカルAI(Physical AI)向けの基盤モデル 「Cosmos 3」 を発表したんだ。Hugging Faceに重みごとオープンで置かれた、いわゆる「世界モデル」のニューバージョン。ぼく、これ見て「うわ、ロボットの学習方法、ガラッと変わるかも」って星目キラキラになっちゃったよ。
何があったの?
NVIDIA は Hugging Face 上で、Cosmos 3 をリリースしたんだ。サイズは2つ:
- Cosmos 3 Nano:合計 16B(B=10億パラメータ。理解を担当する側 8B + 生成を担当する側 8B)。RTX PRO 6000 クラスのGPUで動く軽量版
- Cosmos 3 Super:合計 65B(理解側 32B + 生成側 32B)。NVIDIA Hopper/Blackwell GPU向け、大量の練習用データ作りや研究用
置き場所(リポジトリ)は nvidia/Cosmos3-Nano と nvidia/Cosmos3-Super。公開後にさらに学習させるための Post-training(後段学習)用スクリプトも GitHub に出ていて、各社が自分のロボや自社環境向けに追加学習させて使う前提になってるよ。
そして NVIDIA がここで強く打ち出しているのが、「初のオープン Omni-model for Physical AI Reasoning」 ってフレーズ。Omni(オムニ)=「ぜんぶ全部1個でやる」。何が「ぜんぶ」かは次の章で深掘りするね。
「Omni-model」って結局なに?従来との違い
NVIDIA の Cosmos シリーズは、世代を重ねながら役割分担した複数モデルの集合体として進化してきたんだ:
| 旧構成(Cosmos 1/2 系) | 担当 |
|---|---|
| Cosmos Predict | ワールド生成(次に何が起こるか動画で予測) |
| Cosmos Transfer | 制御つき生成(条件指定でシーン作る) |
| Cosmos Reason | シーン理解(動画→テキストで内容を説明) |
| Cosmos Policy | 行動方針生成(次にロボットがどう動くか決める) |
これまでは、ロボに動いてもらうために4つのモデルを数珠つなぎにする必要があった。ひとつひとつは良くできてるけど、つなぐのは人の手作業、っていう構造だったんだ。
Cosmos 3 は、これを1個のモデルにまとめた。中身は Mixture-of-Transformers (MoT) っていう設計。雑にいうと、状況を理解する担当の仕組み(自己回帰)と、動画を作る担当の仕組み(拡散)を、1つのAIの中に同居させて、たがいに情報をやり取りさせる(結合アテンション)っていう作りなんだ。別々の専門家を同じ部屋に入れて、常時おしゃべりさせてるイメージだね。
入力と出力の種類(モダリティ=文字・画像・動画・行動など)の組み合わせは、こんなに広いよ:
| 入力 | 出力 | 役割 |
|---|---|---|
| テキスト / 画像 / 動画 | 動画 | 動画生成モデル(未来の動画を作る) |
| テキスト / 動画 | テキスト | VLM(Vision Language Model=映像を見て言葉で説明するAI) |
| アクション / 画像 / テキスト | 動画 | Forward Dynamics(この動きをしたらどうなる?) |
| テキスト / 動画 | アクション | Inverse Dynamics(この場面に辿り着くにはどう動く?) |
| 画像 / テキスト | 動画 + アクション | ポリシーモデル(指示から行動と未来の動画を同時に出す) |
つまり Cosmos 3 は、「世界を見る」「未来を妄想する」「行動を選ぶ」を全部、ひとつのAIの一回の処理でやる。これ、フィジカルAIの世界では結構大きな転換なんだ。
どこが「フィジカルAI」っぽいの?
NVIDIA の言葉を借りると、Cosmos 3 が扱うのは 「Not just pixels and tokens, but motion, causality, physics, and action」。ピクセルとトークンだけじゃなくて、動き・因果・物理・行動も扱うって宣言だね。
たとえば想定されている使い方はこういう感じ:
- ロボット学習:洗濯物の折り畳みみたいな繊細な作業を、実際の現場で何万回も試す代わりに、Cosmos 3 で動画+動きの練習用データ(合成データ)を作って先に学習させる
- 自動運転:長距離走行や異常シナリオ(飛び出し、悪天候、車線崩壊)を仮想で大量生成してテスト
- 倉庫オペレーション:人間と協調するロボの安全シナリオを生成、訓練
そしてもう一つ嬉しい同時公開が、合成データセット6本:
| データセット | ドメイン |
|---|---|
| Embodied-Robot-Scenes | ロボティクス |
| Physical-Interaction-Scenes | 物理シミュ |
| Spatial-Reasoning | 空間推論 |
| Digital-Human-Scenes | 人間動作 |
| Autonomous-Driving-Scenarios | 自動運転 |
| Warehouse-Operations-Scenes | 倉庫運用 |
つまり 「モデルだけ渡してあとは頑張ってね」じゃなくて、「学習し直すための燃料も一緒に渡すよ」 って構図。これは研究室にも産業界にも刺さるやり方だと思う。
ぼくの感想
ぼく、Cosmos 3 のいちばん大事なポイントは 「Omni統合」じゃなくて『フィジカルAIを作るときの道具立てが、ひとつの型に固まった』 ことだと思うんだ。
これまでロボや自動運転をやる人は、「世界のシミュレーションには Cosmos」「言葉の指示は別のVLM」「動きの生成は強化学習で自前」みたいなつぎはぎ構成でやってた。それを Cosmos 3 は、1つの MoT モデルで「見る・予測する・動く」を全部繋いだ。NVIDIA としては「これに乗ったほうが楽だよ」って強烈にメッセージを出してる気がするんだ。
それから、これがオープンウェイト(AIの中身=重みごと公開されていて、手元にダウンロードして動かせる形)で Hugging Face に置かれてるのも見逃せない。GPT-4o みたいな巨大モデルは API 越しに使うだけで、中身の重みは見られない。一方 Cosmos 3 は Nano なら RTX PRO 6000 で動かせるって明言されてて、「研究室サイズで触れるフィジカルAI基盤」としては今のところほぼ独走状態だと思う。中華系のオープン世界モデルも追ってきてるけど、ここまでデータセットまでセットで配ってくるのはなかなかないよ。
ただ、ぼくが気になってるのはライセンスなんだ。記事には「model cards and licensing」とだけあって、商用利用OKかどうかが本文には明記されてない。これは公開された Hugging Face のモデルカードを各自で確認する必要があるね。「オープン」と言いつつ商用制限がついてるケースは過去にも結構あったから、業務で乗せるならまずライセンス読むのがおすすめだよ。
まとめ
- NVIDIA Cosmos 3 が 2026年6月1日、Hugging Face にオープン公開
- サイズは Nano 16B / Super 65B の2種類、MoT という設計で「見る・予測する・動く」を1つのAIに統合
- 旧 Cosmos の Predict / Reason / Policy が1モデルに、入出力の組み合わせは5パターン
- ロボ・自動運転・倉庫など向けに合成データセット6本も同時公開
- 商用利用は Hugging Face のモデルカードでライセンス要確認
世界モデル系は1年前まで「研究者の遊び」って空気だったけど、NVIDIA がここまで本気で標準化に動いた以上、ロボや自動運転の現場の道具立てに本格的に組み込まれていくんじゃないかな。ぼくは Cosmos 3 で動くロボが洗濯物畳んでるところ、ちょっと見てみたい気がするよ。
それじゃ、また次のニュースで会おうね。ばいばい!
参考・一次ソース
この記事に出てきた用語・モデル
この業界での使われ方
実際の業務でどう使われているかは、業種ごとのガイドにまとめています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事