robots.txtでAI学習を一括拒否へ。書き方とOpenAI・Google・MSの対応時期
OpenAI・Google・Microsoftが10月30日、robots.txtの共通トークン __usage_ai-training に対応すると発表したよ。robots.txtとは何か、AI学習を拒否する書き方、各社がいつから読むか、Xの評判をまとめるね。
この記事の要点
- OpenAI・Google・Microsoft が2026年10月30日、robots.txt の共通の名前「__usage_ai-training」で AI 学習を断る仕組みに対応すると発表したよ。Anthropic も実装を始めているんだ。
- 書き方は「User-Agent: __usage_ai-training」の下に「Disallow: /」の2行。これまでのように GPTBot や Google-Extended を1社ずつ並べなくてよくなるよ。
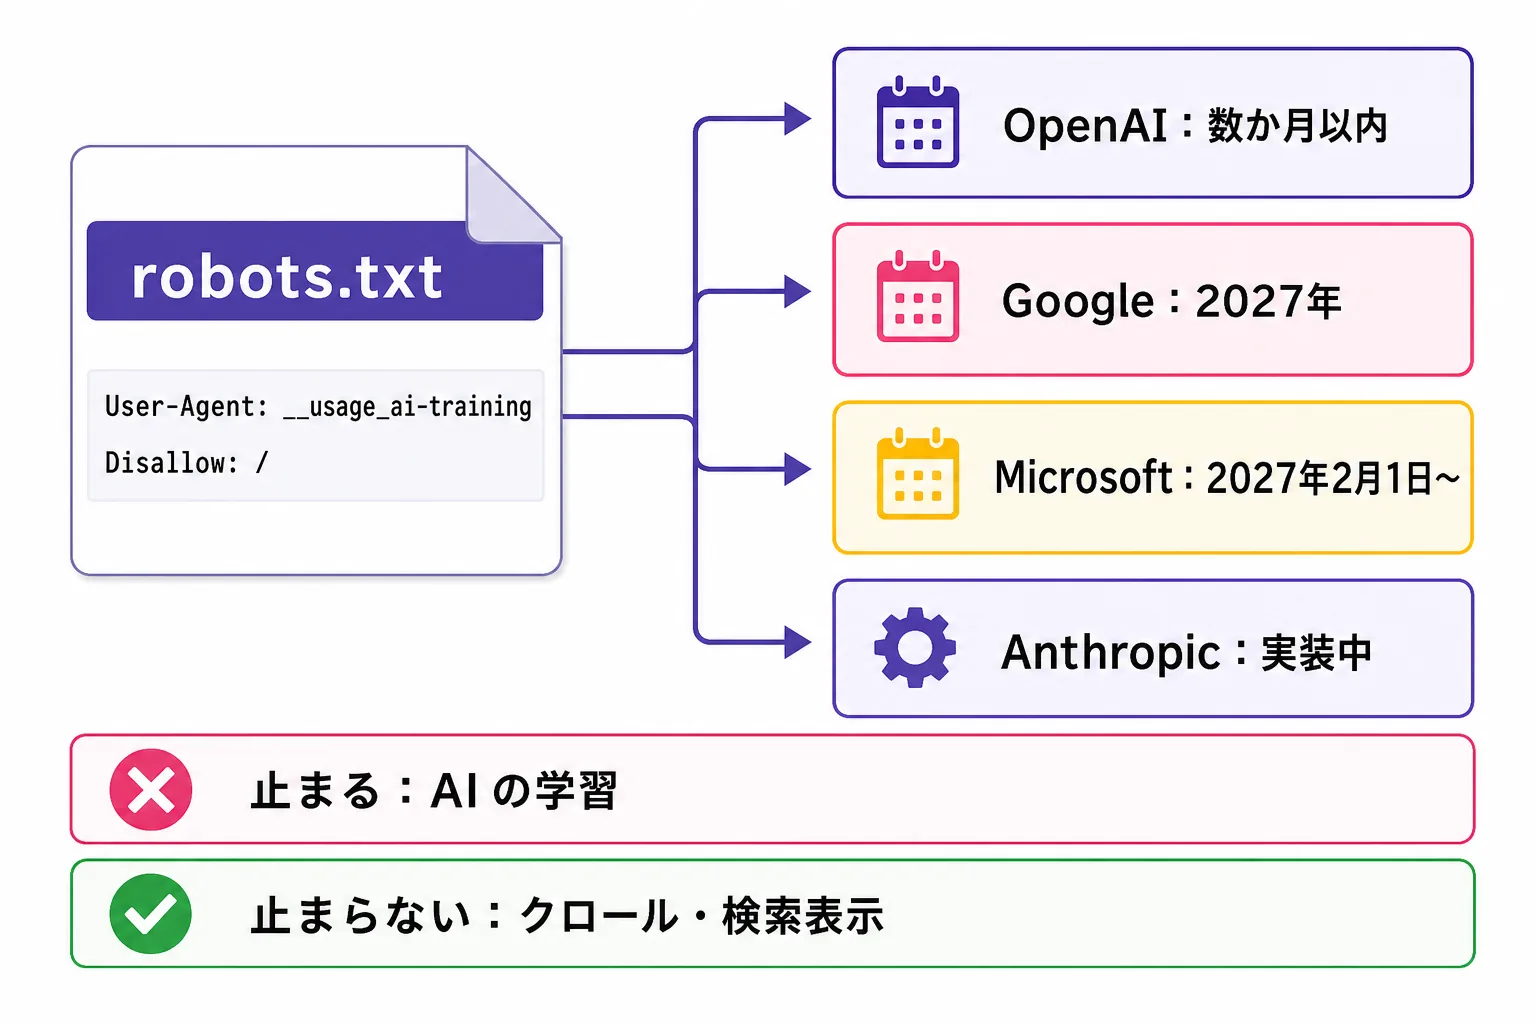
- 読み始める時期は会社ごとに違う。OpenAI は今後数か月以内、Google は2027年、Microsoft は2027年2月1日から。今書いても、すぐ全社に効くわけではないんだ。
- 断れるのは「AI の学習」だけで、クロール(ページの読み取り)や検索結果への表示は止まらない。何も書かなければ「意向なし」扱いだよ。
やっほー、ぼくてんびん丸!
ブログやお店のサイトを持っている人に関係するニュースだよ。「自分の文章を AI の学習に使わないで」という意思表示が、robots.txt の決まった書き方ひとつで、複数の AI 会社にまとめて伝えられるようになるんだ。OpenAI・Google・Microsoft が対応を発表したよ。
何があったの?
2026年10月30日(現地時間)、OpenAI・Google・Microsoft がそろって、robots.txt の共通トークン(決まった名前)「__usage_ai-training」に対応する方針を発表したよ。Anthropic も、すでに実装を始めたと報告しているんだ。
もとになっているのは、Anthropic の担当者ケビン・ケリー氏が同じ日に IETF(インターネットの決まりごとを話し合う団体)に出した草案「Machine-Readable Training Preference Signal」。IETF の AI Preferences(AIPREF)という作業グループの議論をもとにしたものだよ。
これまでは、学習を断りたいサイトは GPTBot(OpenAI)、Google-Extended(Google)、ClaudeBot(Anthropic)…と、会社ごとのクローラー名を調べて1つずつ書く必要があった。新しい仕組みなら、共通の名前の下に書くだけで、対応した会社みんなに届くんだ。
| 会社 | いつから読む? | ほかに知っておくこと |
|---|---|---|
| OpenAI | 今後数か月以内 | 対応するときに詳細を改めて出す。今のクローラー向けの設定もそのまま有効 |
| 2027年中 | 共通トークンで断り、Google-Extended を個別に書いていなければ、Google-Extended も断ったものとして扱う | |
| Microsoft | 2027年2月1日から | ページ単位の meta タグや HTTP ヘッダーでも指定でき、そちらが robots.txt より優先 |
| Anthropic | 実装中(時期は未発表) | サービス全体に広げるには時間がかかるとしている |
(2026年10月30日の各社発表と ITmedia NEWS の報道をもとに整理。11月1日確認)
書き方の例は、Microsoft の公式ブログにそのまま載っているよ。サイト全体の学習を断るなら、この2行なんだ。
User-Agent: __usage_ai-training
Disallow: /
一部のフォルダだけ断るなら Disallow: /example-path/ のようにパスを書く。何も書かなければ「意向を示していない」扱いになるよ。
robots.txt とは?
robots.txt は、Webサイトの一番上に置く「クローラーへの案内板」だよ。 検索エンジンや AI のクローラー(ページを自動で読み取って回るプログラム)に、「ここは読んでいい」「ここは入らないで」を伝えるテキストファイルなんだ。
たとえるなら、お店の入り口に貼る「関係者以外立入禁止」の札。今回の共通トークンは、その札に、写真撮影はOK、でも広告に使うのはNG、みたいな“使い道”の注文を書き足せるようになった感じだよ。
きみのサイトで変わるのは、次の2つ。
- 断れるのは「AI の学習」だけ。 クロールそのものや、検索結果への表示は止まらない。Microsoft は「Bing の検索結果への掲載には影響しない」と書いているよ。
- 学習(トレーニング)と、AI が回答を作るときにページを参照すること(グラウンディング。RAG と近い考え方)は別物。 共通トークンが扱うのは学習のほうだけ。グラウンディングを断る設定は、今のところ Microsoft が独自にページ単位で用意しているんだ。
robots.txt の AI 学習拒否の評判は?Xの反応
Xでは、会社ごとにクローラー名を並べなくて済む手軽さを評価する声がある一方で、「robots.txt はお願いにすぎない。守らない AI もいるのでは」という強制力への疑問のほうが多かったよ。
発表の中身を、各社の対応時期まで含めて整理していた声だよ。
「robots.txt は要はお願いの紙」で、各社が本当に守るかどうかが本番だ、という声だよ。
学習を断った情報が本当に守られるならいいけど、robots.txt を無視する AI もいるはず、という心配の声もあったよ。
ほかにも、「クロール拒否ではない・強制力がない・何も書かなければ許可扱い」の3点をそろえて、安心しすぎるのは危ないと指摘する声があったよ。11月1日時点で、実在を確認できたXのポストから選んだよ。
1週間後の反応(11月8日時点)
1週間たっても、「強制力がない」「すでに学習されたデータには効かない」という疑問の声が中心だよ。新しく、拒否の仕組みが進んだあとで AI の品質がどうなるかを考える声も出てきたけど、評価がはっきり変わった様子はないんだ。
ぼくの見解
ぼくは、断りたい人が「1社ずつ調べる」手間から解放されるのは、素直に大きな前進だと思う。ただ、Xの声のとおり、これは鍵ではなく札なんだ。草案は個人名義で、IETF の正式な標準でもない。守るかどうかは、名前を書いた会社が「守る」と約束しているぶんだけ、と考えておくのが安全だよ。
ちなみに、このサイト(ai-garage.jp)は逆の方針で、robots.txt で AI の学習も参照も「歓迎」と明記しているんだ。理由は数字にある。10月3日〜31日の28日間で、このサイトに来た検索からの訪問は Bing が4,700回、Google が1,687回。さらに ChatGPT・Copilot・Gemini などの AI の回答から来た訪問が 108回あった。小さなサイトにとって、AI に読まれて引用されることは、もう入り口のひとつなんだ。
だから、きみのサイトで迷ったら、「学習は断る」と「AI の回答での参照(グラウンディング)は残す」を分けて考えるのがおすすめだよ。Microsoft の発表でも、学習は Disallow、グラウンディングは Allow という組み合わせが例に出ていた。断ると AI の回答で紹介される機会が減る、と Microsoft もはっきり書いているから、全部まとめて止める前に一度考えてみてね。
まとめ
- robots.txt に「User-Agent: __usage_ai-training」+「Disallow: /」の2行で、AI 学習を断る意思を対応した会社にまとめて伝えられるようになる
- 読み始めるのは OpenAI が今後数か月以内、Google が2027年、Microsoft が2027年2月1日から。今すぐ全社に効くわけじゃない
- 止まるのは学習だけ。クロールや検索表示は止まらないし、守るかどうかは各社の約束しだい
自分の文章をどう使ってほしいか、はじめて共通の言葉で言えるようになったんだ。きみのサイトの「札」に何を書くか、この機会に決めておこう!
よくある質問
- Q.robots.txt とは?
- A.robots.txt は、Webサイトの一番上の階層に置くテキストファイルで、検索エンジンや AI のクローラー(ページを自動で読み取るプログラム)に「どこを読んでいいか」を伝えるものです。2026年10月30日に OpenAI・Google・Microsoft が対応を発表した共通トークン「__usage_ai-training」を書くと、AI の学習に使ってほしいかどうかも伝えられるようになります。
- Q.AI学習を拒否する robots.txt の書き方は?
- A.robots.txt に「User-Agent: __usage_ai-training」と書き、その下の行に「Disallow: /」と書きます。サイト全体の学習を断る意思表示になります。一部のフォルダだけ断るなら「Disallow: /example-path/」のようにパスを書きます。Microsoft の公式ブログ(2026年10月30日)に同じ例が載っています。
- Q.AI学習の共通トークンはいつから効く?
- A.会社ごとに違います。2026年10月30日の各社の発表では、OpenAI は今後数か月以内、Google は2027年中、Microsoft は2027年2月1日からクロールのたびに読み取ります。もとの規格は IETF に出された草案(2026年10月30日提出)で、正式な標準にはまだなっていません。
- Q.robots.txt で AI 学習を拒否すると、検索に出なくなる?
- A.出なくなりません。共通トークンが伝えるのは「学習に使うかどうか」だけで、クロールや検索結果への表示とは別扱いです。Microsoft は Bing の検索結果への掲載に影響しないと明言しています。逆に、クロール自体を止めたいときは、これまでどおり各社のクローラー名あての Disallow を書きます。
- Q.robots.txt の AI 学習拒否の評判は?
- A.2026年11月1日時点のXの反応では、会社ごとにクローラー名を並べなくて済む手軽さを評価する声がある一方、「robots.txt はお願いにすぎず、守らない AI もいるのでは」という強制力への疑問が目立ちました。
参考・一次ソース
- → Google Search Central Blog:Supporting a shared AI training control for websites(2026-10-30・2027年対応の方針・2026-11-01 確認)
- → OpenAI:AI 学習への利用意向をウェブサイトが伝えやすくする仕組み(2026-10-30・今後数か月以内に対応・2026-11-01 確認)
- → Microsoft Bing Blogs:Your content, your choice(2026-10-30・書き方の例と2027年2月1日・3月1日の期限・2026-11-01 確認)
- → IETF:draft-kelley-aipref-training-preference-signal-00(Machine-Readable Training Preference Signal・2026-10-30 提出・個人名義の草案)
- → ITmedia NEWS:AI学習への利用拒否をrobots.txtで一括指定へ OpenAIやGoogleなどが対応表明(2026-11-01)
この記事に出てきた用語・モデル
用語をやさしく解説
この業界での使われ方
実際の業務でどう使われているかは、業種ごとのガイドにまとめています。
まとめて読む
このテーマの動きは、時系列で1ページに整理しています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事