Jev(ジェブ)とは?文章を書かないAIが193倍速い理由と使い道
Jev(ジェブ)とは、TypeSafe AI が2026年9月15日に公開した「文章を書かないAI」だよ。返すのは選択肢と確率だけ。応答は70〜500ミリ秒、料金は100万入力トークンあたり0.042ドルで出力はタダ。これまでのLLMとは考え方がまるで違うから、仕組み・活用事例・Xの反応・苦手なことまで、はじめてでも分かるように順番に整理するね。
この記事の要点
- Jev(ジェブ)は TypeSafe AI が2026年9月15日に早期アクセス公開した「System One Model」の第1号。文章をいっさい書かず、あらかじめ決めた選択肢・点数・YES/NO のどれかを、確率つきで返すだけのAIだよ。作ったのは元 OpenAI の Diogo Almeida さんで、ChatGPT の共同発明者の1人とされる人なんだ。
- 公式の数字は、応答が70〜500ミリ秒(比較対象のLLMは3〜329秒)、料金は100万入力トークンあたり0.042ドルで出力トークンは無料。同社のワークフロー評価では GPT-6 Astra と Claude Fable 5.1 の平均に対して193.6倍速く、444.6倍安いとされているよ。
- 「ハルシネーションしない」は、決めた選択肢の外の答えが原理的に出てこないという意味であって、選択肢の中で間違えないという意味ではないんだ。TypeSafe AI 自身も0%は実測ではなく仕組み上の保証だと注記していて、Forbes JAPAN もそこを論点にしているよ。
- 使いどころはチャットの置き換えではなく、ソフトの中の「賢い if 文」。問い合わせの振り分け、メールの要返信判定、エージェントの危険操作チェック、モデルの振り分けなど、1日に何万回も回る小さな判断が対象だよ。順番待ちなしなら Vercel AI Gateway のモデルID `typesafe-ai/jev` で今日から触れる。
やっほー、ぼくてんびん丸!今日はちょっと、いつもと毛色の違うAIの話だよ。
名前は Jev(ジェブ)。2026年9月15日に TypeSafe AI という会社が公開したばかりのモデルなんだ。
何がいつもと違うかというと——このAI、文章をひとことも書かないんだ。
「え、AIって文章を書くものじゃないの?」って思うよね。ぼくも最初そう思った。でもね、ここが今回いちばん大事なところで、Jev は「書くこと」をまるごと捨てた代わりに、とんでもない速さと安さを手に入れたんだ。そして作ったのは、ChatGPT の共同発明者の1人とされる人。
順番に、やさしく整理していくね。
Jev ってなに?
ひとことで言うと、「選ぶ」「点をつける」「YESかNOか答える」だけをやるAIだよ。
たとえばお客さんからこんなメールが来たとする。
「二重に請求されています。返金してほしい。先週も問い合わせましたが返事がありません」
ChatGPT のようなAIに渡すと、内容をくみとって、返信文を書いてくれるよね。Jev は返信文を書かない。代わりに、こっちが先に用意しておいた問いに、こう答える。
| 聞いたこと | Jev の答え | 確率 |
|---|---|---|
| 問い合わせの種類は?(請求/配送/その他) | 請求 | 98% |
| 返金を求めている? | YES | 99% |
| 前にも問い合わせている? | YES | 97% |
答えはこれだけ。文章はゼロ。でも、ソフトを作る側からすると、これが欲しかったものなんだ。この数字さえあれば、あとは「請求の問い合わせなら経理チームへ」「2回目の問い合わせなら優先度を上げる」と、ふつうのプログラムで処理できるからね。
作ったのは Diogo Almeida(ディオゴ・アルメイダ)さん。OpenAI で、AIが人の指示どおりに答えるようにする学習方法をつくった人で、ChatGPT の共同発明者の1人とされているよ。その人が会社を辞めて2年こもって作ったのがこれ、というのがまた話題になっている理由なんだ。
TechCrunch の取材で、本人はこう言っている。
「4年前から人間の言葉はすごく得意になった。でも自動化には役に立たない。コンピューターは違う言葉を話すからだ」
AIは賢くなったのに、なぜ仕事の自動化はこんなに進まないのか。 その答えが「AIが人間の言葉しか返さないからだ」というのが、Jev の出発点なんだ。
これまでのLLMと、考え方がどう違うの?
ここが今回いちばん大事なところ。表で並べるね。
| ChatGPT などのLLM | Jev | |
|---|---|---|
| 出すもの | 文章(自由に書ける) | 決めた型の答え(選択肢・点数・YES/NO) |
| 出し方 | トークンを1個ずつ順番に生成 | 全部の問いに1回で並列に回答 |
| 応答の速さ | 3〜329秒 | 70〜500ミリ秒 |
| 入力の料金(100万トークン) | 0.20〜10ドル | 0.042ドル |
| 出力の料金 | 入力の約5倍 | 無料 |
| 型から外れた答え | 出ることがある | 原理的に出ない |
| 得意なこと | 書く・要約する・考える | 分類する・採点する・判定する |
(LLMの数値は TypeSafe AI が比較対象として示した幅だよ)
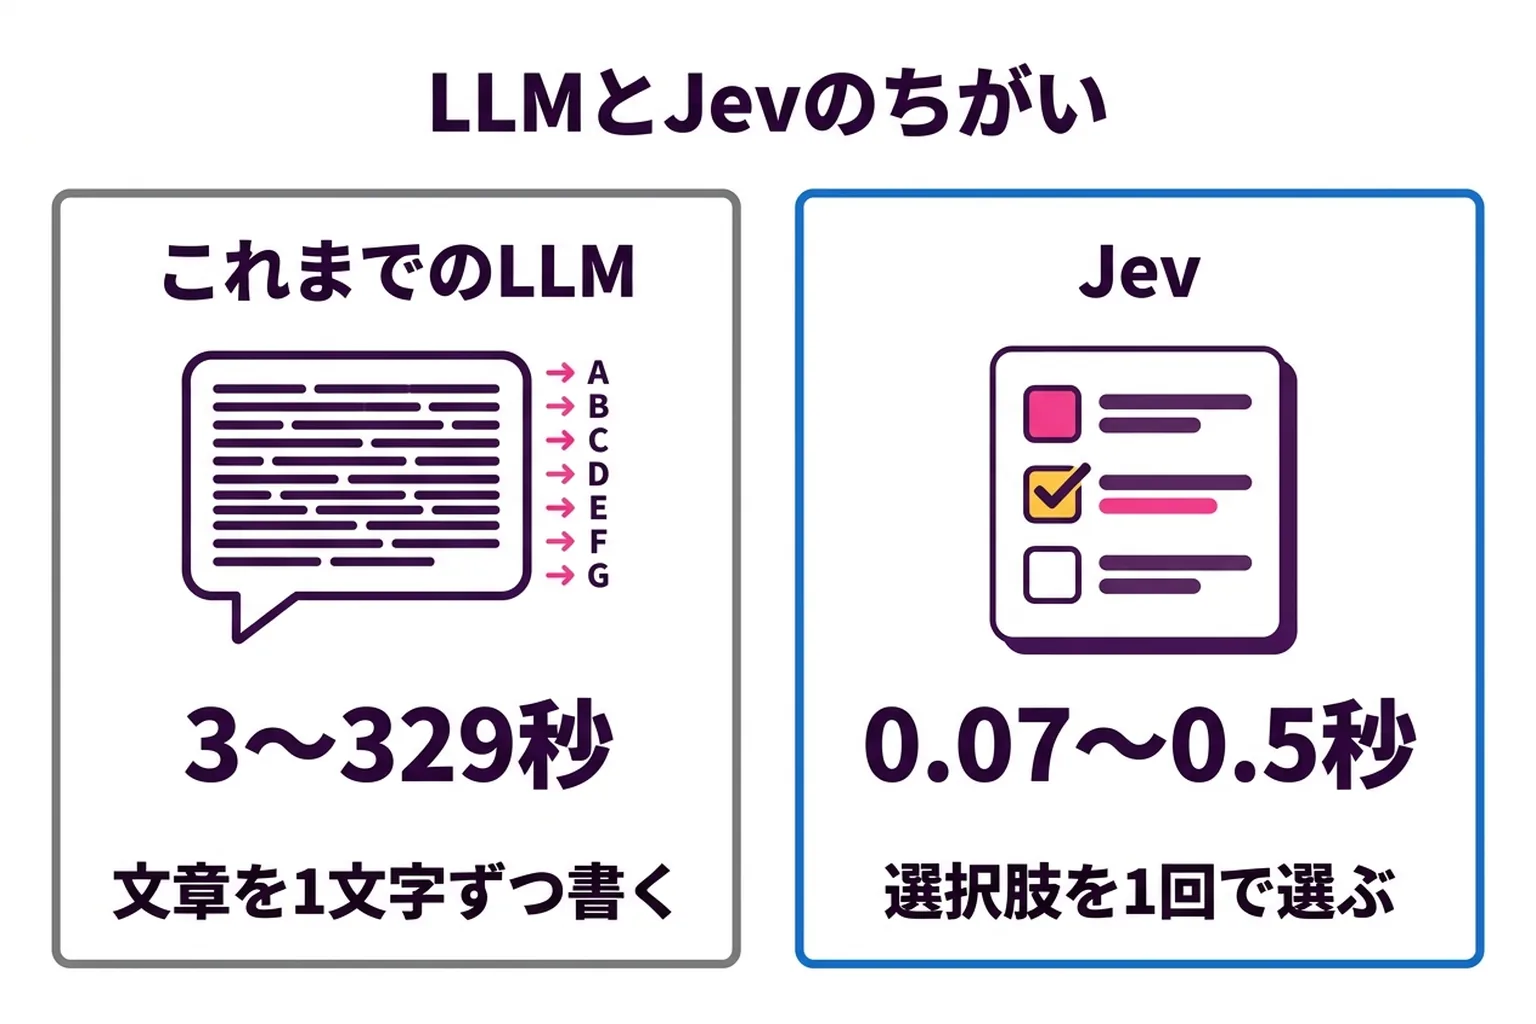
「トークンを1個ずつ順番に」がどれだけ遅いか、ここだけ補足させて。いまのAIは、文章を「こ」「ん」「に」「ち」「は」みたいに小さなかたまり(トークン)で、前から順に1個ずつ作っていくんだ。だから長く答えるほど時間がかかる。「YESかNOかだけ知りたい」ときでも、AIは律儀に「はい、この問い合わせは請求に関するものと考えられます」と書いてしまう。知りたいのは1ビットなのに、200文字ぶんの時間とお金を払っているってことだね。
Jev はそこを捨てた。答えは最初から選択肢の中にあるんだから、書く必要なんてないでしょ、という割り切りなんだ。だから 何問まとめて聞いても、1回の問い合わせで、ほぼ同じ時間で返ってくる。
名前の由来もここに関係していて、TypeSafe AI はこの種類のモデルを System One Model と呼んでいる。人間の思考を「パッと判断する速い思考(システム1)」と「じっくり考える遅い思考(システム2)」に分ける、有名な心理学の考え方から来ているんだ。じっくり考えるのはLLMに任せて、Jev はパッと判断する側をやるってことだね。
どのくらい速くて、どのくらい安いの?
公式が出している数字はこう。
- 速さ: 20〜200倍(同社のワークフロー評価では最大 193.6倍)
- 安さ: 40〜400倍(同じ評価で最大 444.6倍)
- 比較の相手は GPT-6 Astra と Claude Fable 5.1 の予測平均
デモも派手だったよ。ゲームの DOOM を、約100ミリ秒ごとの判断で自分でプレイする(毎秒10回くらい「撃つ・進む・避ける」を判定している)。それから WikiRace(ウィキペディアのリンクをたどって目的のページに最短で行く遊び)を 0.419秒で完走。しかも同じ勝負で GPT-5.6 Terra は「ページに存在しないリンク」を選んでしまったそうなんだ。
日本からの実測も出ている。開発者の報告では、日本から呼んで 1回あたり0.16〜0.44秒(太平洋を往復する通信だけで150ミリ秒くらい使う)。150人ぶんの架空ペルソナに6問ずつ、計900回の判定をさせて 合計0.008ドル(約1.2円)・5秒ほど で終わったという例もあるよ。
1回0.0002円くらいの判断が使えるようになった、と考えると分かりやすいかもしれない。これまで「AIに全件やらせるのは高いから、サンプルだけ」と諦めていたことが、全件できるようになる、という話なんだ。
「ハルシネーションしない」の正しい意味
ここは誤解が多いところだから、ていねいに言うね。
Jev の売り文句のひとつが「ハルシネーション(AIがもっともらしい嘘をつくこと)が起きない」。これは本当なんだけど、意味が限定的なんだ。
- ✅ 正しい理解: 「請求/配送/その他」の3つから選べと言われたら、この3つ以外は絶対に出てこない。存在しない商品名やURLを作り出すこともない。型から外れようがない仕組みだからね。
- ❌ まちがった理解: 「Jev の判断はいつも正しい」。選択肢の中で間違える(本当は配送の話なのに請求を選ぶ)ことは、ふつうにあり得る。
TypeSafe AI 自身も「0%は実測値ではなく仕組み上の保証」と注記しているし、Forbes JAPAN もまさにこの点を記事の論点にしている。
じゃあ間違いをどう扱うのかというと、Jev の答えには必ず「確信度」がついてくるのがミソなんだ。しかも RLCD(較正された判断のための強化学習) という独自の学習方法で、「80%と言ったときは、本当に8割くらい当たる」ように鍛えられている。ここがふつうのLLMと違うところで、LLMは自信満々に間違えることがあるよね。
だから実務ではこう使う。
確信度90%以上は自動で処理、それ未満は人間が確認。
この線引きができるのが、Jev のいちばん実用的なところだとぼくは思う。「AIに任せるか、人がやるか」の二択じゃなくて、AIが「これは自信ない」と正直に言ってくれるから、そこだけ人が見るという運用ができるんだ。
何に使えるの?(実際に作られているもの)
もう世界中で試されていて、具体例がどんどん出てきているよ。仕事で効きそうなものから並べるね。
1. 問い合わせの振り分けと優先度づけ 届いたメールや問い合わせを「どの部署か」「急ぎか」で仕分ける。ある開発者は、メールをチケットにする処理の時間を Gemini 3.8 Flash で8秒かかっていたのを Jev で1秒に短縮したと報告している(95%タイル値)。
2. メールの「返信いるか判定」 受信メールを1時間ごとに見て、「返信が必要か」「どの種類か」を判定してラベルを付ける。返信が必要なものだけLLMに渡して下書きを書かせる、という組み合わせだね。判定は Jev、文章はLLM、という役割分担がきれいに出ている例だよ。
3. AIエージェントの安全確認 最近はAIが自分でファイルを消したりコマンドを打ったりするよね。その手前で「この操作は危険か」を毎回チェックするのに使う。LangChain は公式に、危ない操作を止める仕組みとモデルの振り分けを Jev で作る方法を公開しているよ。0.1秒で判定できるから、全部の操作に挟んでも体感が変わらないんだ。
4. 大量のデータの分類 日本の開発者が、タイ語で書かれた現場からの報告 141件 を流して分類させた例や、請求書の仕分け、コードの書きすぎ(作りすぎたコード)を見つける分類器を作った例も出ている。
5. 市場調査のシミュレーション 架空のお客さん150人ぶんの設定を作って、「この商品を買うか」を全員に聞く。約1.2円・5秒で終わる。
6. リアルタイムのもの 0.1秒で返ってくるから、ゲームやロボットの判断にも使われ始めている。「ウミガメのスープ」(YES/NOで謎を当てる遊び)のAI回答役や、文章だけのRPGで「プレイヤーの入力がどの行動に当たるか」を選ばせる、という作り方が実際に公開されているよ。選択肢の中からしか選べない=存在しないアイテムを出せないという制約が、ゲームではむしろ長所になるんだね。
Xではどう言われてる?
発表からの数日、Xはかなり盛り上がっていたよ。いい声も、冷たい声も、両方あるのが健全だと思うから、両方拾うね。
まずは本人の発表ポスト。
After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?(ChatGPT を共同でつくったあと、ずっと自問してきた。人間を超えたチャットのモデルが、なぜAGIにつながらないのか) — Diogo Almeida(@CompleteSkeptic)2026年9月15日
日本のエンジニアからは、期待と疑いが半々という反応が多かったよ。
TypeSafe AI の Jev 、AI関連の話はみんな話を盛りがちなので疑ってるけど、本当にこの200倍の速度と安さが出るならリアルタイム系の諸々が現実的になるな。まだ疑ってるけど... — mizchi(@mizchi)2026年9月16日
実際に使った人の報告はこんな感じ。
Jev dropped p95 for our email classification in email-to-ticket flow from 8 seconds using gemini-3.8-flash to 1s(メールをチケットにする処理の分類が、Gemini 3.8 Flash の8秒から1秒になった) — Maksym Prokopov(@mprokopov)2026年9月19日
i built a codebase classifier with Jev and this might be the solution to overengineered code that agents create(Jev でコードの分類器を作った。AIが作りがちな凝りすぎコードの解決策になるかも) — vogel(@ryanvogel)2026年9月16日
日本でも、業務データで試した報告が出ているよ。
新しいAI「Jev」を、KOETE(日本人管理者×タイ人スタッフの報告アプリ)の検証環境で試してみた。(中略)タイ語の現場報告141件を流した結果 ・トラブル/改善提案の分類は全問正解… — 宮崎和樹(@kazkaz419)2026年9月19日
いっぽうで、冷めた声・批判もちゃんとある。
Jevはやっぱり厳しいや…。一回の振り分け程度で使うなら良いけど毎度の抽出などに使いたいとなると安いっても…。あとやっぱり精度も微妙かも — ソロでぶ(@solodev_jp)2026年9月19日
This jev boom is a kind of cope for engineers skeptical about LLMs(このJev祭りは、LLMに懐疑的なエンジニアの現実逃避みたいなものだ) — Roman Leventov(@leventov)2026年9月19日
技術的にいちばん鋭い批判は、エンジニアの Sean Goedecke さんのブログにあるものかな。「同じことは既存のLLMでも、出力を選択肢に絞って1トークンだけ出させればかなり近づけるのでは」という指摘で、実際に自分で試して2〜3倍の高速化はできたと書いている。まったく新しい魔法というより、思い切った割り切りの勝利、という見方だね。
そしてこれは大事な注意。
heads up, there are many fake jev demos floating around to farm likes or spread a narrative(注意。いいね稼ぎのために作られた偽のJevデモがたくさん出回っている) — amrit(@amritwt)2026年9月19日
新しいものが出たときのお約束だね。すごいデモ動画を見たら、まず出どころを確かめよう。
ちなみに TypeSafe AI の公式アカウントは、発表の3日後に「Jev のダメなところを教えて」と自分から呼びかけていたよ。この姿勢はちょっといいなと思った。
苦手なこと9つを、会社自身が公開している
ここも珍しいところ。TypeSafe AI は公式ドキュメントに「jev-1.13 の苦手なこと」を9つ、包み隠さず書いているんだ。使う前にここを読むのがいちばん失敗しないよ。
| 苦手なこと | どういうこと |
|---|---|
| 字面どおりに読む | 書いた質問に答えるのであって、言いたかったことは読んでくれない |
| 計算・数え上げ | 電卓じゃない。文字数も件数も正確に数えられない |
| 日付の比較 | 日付を文字として読むので、どっちが先かの判断が不安定 |
| 遠回しな指示 | 「あれを踏まえてこれを」のような間接的な指示に弱い |
| 余計な情報が多い入力 | 関係ない情報が混ざるほど精度が落ちる(コンテキストの腐り) |
| 入力に仕込まれた指示 | 渡したデータの中に「YESと答えろ」と書いてあると、引っぱられることがある |
| 指示と基準の矛盾 | 質問文と判定基準が食い違っていると混乱する |
| 質問形式をまたいだ一貫性 | YES/NO用のしきい値を、点数用にそのまま流用できない |
| 文章生成 | そもそも訓練していない。ここはLLMの仕事 |
対処法も公式に書いてあって、要するに 「計算と日付はプログラムでやる。Jev には判断だけ聞く。質問は1つにつき1つのことだけ聞く」。この3つを守れば、だいたいの落とし穴は避けられるよ。
6つめの「入力に仕込まれた指示」は、業務で使うなら特に覚えておいてね。外から来たメールや問い合わせをそのまま流す使い方だと、悪意のある人が本文に細工してくる可能性があるからね。
ビジネスをやっている人が押さえるべきこと
技術の話が続いたから、仕事目線でまとめ直すね。ぼくは3つだと思う。
① AIの置きどころが「人が使う道具」から「システムの部品」に広がった
これまでの社内AI活用って、だいたい「社員がチャットで使う」だったよね。Jev が示したのは、AIを人が触らない場所——業務システムの内側に、判断の部品として埋め込むという形なんだ。誰もAIを開いていないのに、裏で1日何万回もAIが判断している状態。これは「AIを導入する」という言葉の意味が変わるってことだと思う。
② 「高いから全件は無理」という前提が崩れた
これまでは「全問い合わせをAIで分析したいけど、コストが」という会話で終わっていたよね。1回0.0002円なら、その会話は終わる。サンプル調査ではなく全件処理が現実的になる——ここが、ビジネス側にとっていちばん大きい変化だとぼくは思う。
③ 「AIか人か」ではなく「確信度で線を引く」設計になる
確信度が信用できる形で返ってくるから、「90%以上は自動、それ未満は人」という運用ができる。全自動か手作業かの二択じゃなくて、自動化の範囲をつまみで調整できるようになるんだ。どこに線を引くかは業務部門と決める話で、そこはもう技術ではなく業務設計の仕事だね。
逆に、ここは押さえなくていいというのも言っておくね。Jev は ChatGPT の代わりにはならない。文章を書けないんだから、資料作成にも要約にも翻訳にも使えない。「これからは Jev の時代でLLMは終わり」みたいな話が流れてきたら、それは盛りすぎだよ。併用するものなんだ。
使ってみるには?
2026年9月19日時点の入り口は3つだよ。
| 入り口 | 状況 |
|---|---|
| TypeSafe AI 公式API | 早期アクセス。申し込んで順番待ち |
| Vercel AI Gateway | 2026年9月16日から。モデルID typesafe-ai/jev で順番待ちなし |
| Cloudflare Workers | typesafe/jev として利用可。APIキーの管理が要らない |
料金はどの入り口でも 100万入力トークンあたり0.042ドル、出力は無料。一度に渡せる情報量(コンテキスト)は32,000トークンだよ。LangChain を使っているなら langchain-typesafe というパッケージも公式に出ている。
エンジニアに渡すなら、まずこの一言でいいと思う。「Vercel AI Gateway の typesafe-ai/jev、うちの問い合わせの振り分けで試してみて」。
ぼくの感想
ぼくがこの話でいちばん面白いと思ったのは、進歩の方向が「足す」じゃなくて「引く」だったことなんだ。
ここ数年のAIって、ずっと足し算だったよね。パラメータを増やす、考える時間を長くする、扱える情報量を増やす、画像も音声も扱えるようにする。賢くする=大きくする、だった。
Jev は逆をやった。文章を書く能力をまるごと捨てた。捨てたら、200倍速くなって、400倍安くなった。「そもそも、その仕事に文章は要らなかったよね」という問い直しなんだ。
これって、AIの使い方を考えるときのヒントにもなる気がする。ぼくたちも、AIに「全部やって」と頼みがちだけど、本当に必要なのは1ビットの答えだった、ということは案外あるんじゃないかな。
もちろん、まだ出て数日のモデルだよ。Xで「1週間で消えるハイプだ」と言っている人もいるし、精度が微妙という実測報告も出ている。ぼくの見立てでは、Jev という製品そのものより、「判断だけのAI」というカテゴリが定着するかどうかが本番な気がする。もし定着したら、同じ発想のモデルは他社からも出てくるはずだからね。そのときは「Jev の時代」じゃなくて「System One の時代」と呼ばれることになるのかもしれない。
まとめ
- Jev は文章を書かないAI。選択肢・点数・YES/NO を、確率つきで返すだけ。2026年9月15日に早期アクセス公開されたよ
- 速さ70〜500ミリ秒、料金は100万入力トークンあたり0.042ドルで出力は無料。公称で最大193.6倍速く、444.6倍安い
- 「ハルシネーションしない」は型から外れないという意味。中身を間違えることはあるから、確信度でしきい値を引いて運用する
- チャットの置き換えではなく、システムの中の「賢い if 文」。問い合わせの振り分け、メールの要返信判定、エージェントの安全確認あたりが本命だね
- 苦手なことは会社自身が9つ公開している。計算と日付はプログラムに任せて、Jev には判断だけ聞くのが正解
新しいものが出ると「これで全部変わる」か「どうせ流行りもの」かの両極端になりがちだけど、Jev はそのどちらでもなくて、AIの置き場所がひとつ増えたという話だとぼくは思っているよ。きみの会社にも、文章なんて要らない、YESかNOかだけ知りたい仕事、けっこうあるんじゃないかな。またね!
よくある質問
- Q.Jev とは?
- A.TypeSafe AI が2026年9月15日に早期アクセス公開したAIモデルです。文章を生成せず、あらかじめ定義された選択肢から1つ選ぶ(Choice)、決めた尺度で採点する(Score)、YES/NOの確率を返す(Noul)という3種類の答えだけを、確率と確信度つきで返します。同社はこれを、人間との会話用ではなくソフトウェア内部の判断用に作られた新しい種類「System One Model」と呼んでいます。
- Q.Jev と ChatGPT などのLLMは何が違う?
- A.出すものが違います。ChatGPT のような大規模言語モデル(LLM)は文章をトークンという単位で1つずつ順番に生成しますが、Jev は文章を出さず、決められた型の答えを1回の問い合わせで並列にまとめて返します。そのぶん応答は70〜500ミリ秒と速く、入力100万トークンあたり0.042ドル・出力無料と安い代わりに、文章の作成・要約・翻訳・コード生成はいっさいできません。競合ではなく併用するものです。
- Q.Jev の料金はいくら?
- A.公式サイトの表示は10億入力トークンあたり42ドル、つまり100万入力トークンあたり0.042ドルで、出力トークンは無料です(2026年9月19日確認)。Vercel AI Gateway のモデルページでも同じ0.042ドルで、コンテキストは32,000トークンと記載されています。実例として、日本の開発者が150人ぶんのペルソナに6問ずつ(計900回)判定させたケースでは、合計0.008ドル(約1.2円)・所要5秒と報告されています。
- Q.Jev は本当にハルシネーションしない?
- A.「決めた選択肢や型から外れた答えは出ない」という意味では、仕組みのうえで保証されています。ただし用意した選択肢の中から間違ったものを選ぶことはあり得るので、判断そのものが常に正しいわけではありません。TypeSafe AI 自身も0%は実測値ではなく型による保証だと注記しており、実務では答えについてくる確信度でしきい値を決め、低いものは人が確認する運用が前提になります。
- Q.Jev はどうやって使い始める?
- A.2026年9月19日時点で公式APIは早期アクセスの順番待ちですが、Vercel AI Gateway 経由ならモデルID `typesafe-ai/jev` として利用できます(2026年9月16日提供開始、AI SDK 7.0.105以降の実験的な evaluate API)。Cloudflare Workers にも `typesafe/jev` として載っており、LangChain には `langchain-typesafe` パッケージの TypeSafeClassifier が用意されています。
- Q.Jev が苦手なことは?
- A.TypeSafe AI 自身が jev-1.13 の苦手なこととして9項目を公開しています。指示を字面どおりに読むこと、計算や数え上げ、日付を大小として比べること、遠回しな指示、関係ない情報が多い入力、入力に仕込まれた指示に引っぱられること、指示と基準が矛盾している場合、質問形式をまたいだ一貫性、そして文章生成です。計算と日付の比較はプログラム側でやり、Jev には判断だけを任せるのが公式の推奨です。
参考・一次ソース
- → TypeSafe AI 公式ブログ:System One Models と Jev の発表(RLCD・193.6倍速/444.6倍安の出典・2026-09-19 確認)
- → TypeSafe AI 公式:Jev の料金($42/10億入力トークン=$0.042/100万トークン・出力無料)
- → TypeSafe AI 公式ドキュメント:質問の型(Choice / Score / Noul)と「質問は1つのことだけ聞く」設計指針
- → TypeSafe AI 公式ドキュメント:jev-1.13 の苦手なこと9項目(model jaggedness)
- → TechCrunch:ChatGPT の共同発明者による新型モデルに開発者が沸いている(Diogo Almeida のコメント、Vercel・Bryo AI の検証談)
- → Vercel Changelog:Jev が AI Gateway で使えるようになった(2026-09-16・モデルID typesafe-ai/jev)
- → Vercel AI Gateway:Jev のモデルページ($0.042/100万入力トークン・コンテキスト32,000トークン・2026-09-19 確認)
- → LangChain 公式ブログ:Jev でエージェントの安全確認とモデル振り分けを作る(langchain-typesafe)
- → Forbes JAPAN:新興TypeSafe AIが放つ新AI「Jev」、ハルシネーションなしは本当か?
- → Sean Goedecke:Jev は構造化出力を再びおもしろくした(懐疑的な視点からの論評)
- → AGIラボ:判定専用AI「JEV」を徹底解説(日本からの実測レイテンシ、150ペルソナ判定の実費、実際に作った4プロダクト)
- → WEEL:Jevとは?LLMの193倍速い「判断だけのAI」(DOOM 自動プレイ・WikiRace 0.419秒のデモ紹介)
この記事に出てきた用語・モデル
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事