NEWS (7)
ニュース
2026/8/7
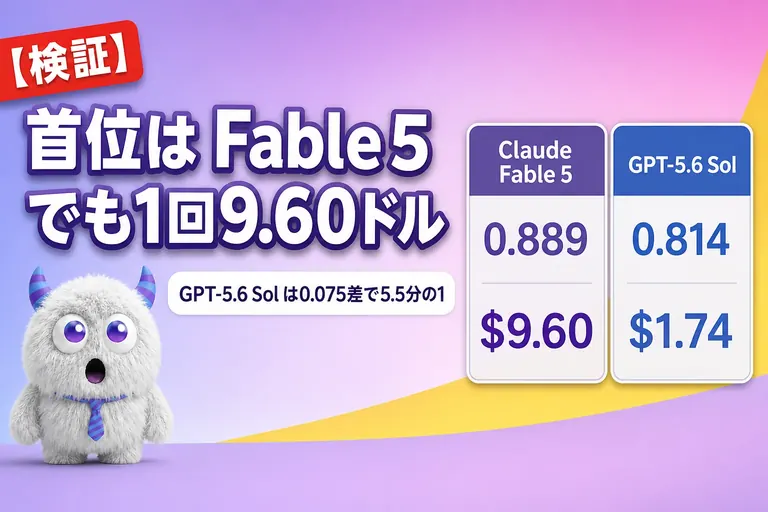
Claude Fable 5 と GPT-5.6 はどっちが強い?物理シミュ検証で首位は Fable 5、でもコストは Sol の5.5倍——差を分けたのはモデルより「道具」だったよ
JuliaHub が物理シミュレーションの5問で Claude Fable 5 と GPT-5.6 の3兄弟を比べたよ。スコア1位は Fable 5(0.889)だけど1回あたり9.60ドルで、GPT-5.6 Sol(0.814・1.74ドル)の約5.5倍。しかも同じモデルでも使う道具立てを替えると0.366点動いて、モデル間の差0.162点の2倍以上だったんだ。
2026/8/5
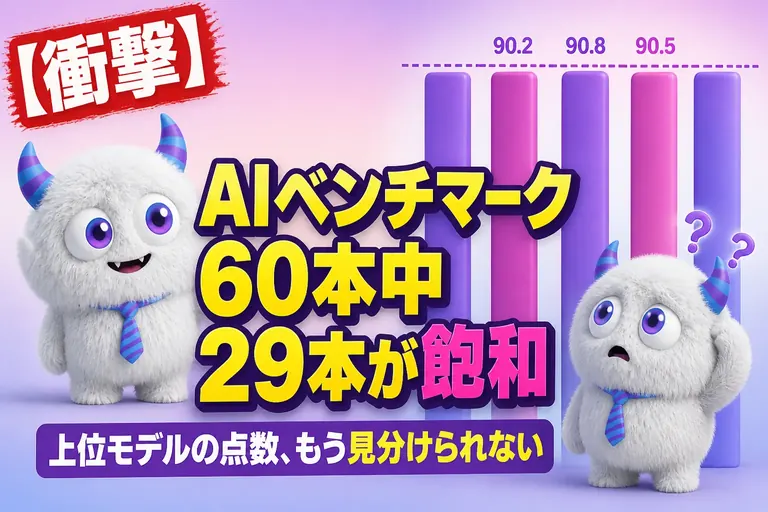
AIのベンチマークはもう限界?60本中29本が「飽和」、ICML 2026採択の研究で分かった性能比較の落とし穴だよ
AIのベンチマークはもう限界?ICML 2026 採択の研究では60本中29本(約48%)が「飽和」=上位モデルの点数が誤差の範囲でしか違わない状態だったよ。古いものほど飽和しやすく、24か月以内42.9%に対し60か月超は54.5%だったんだ。
2026/7/30
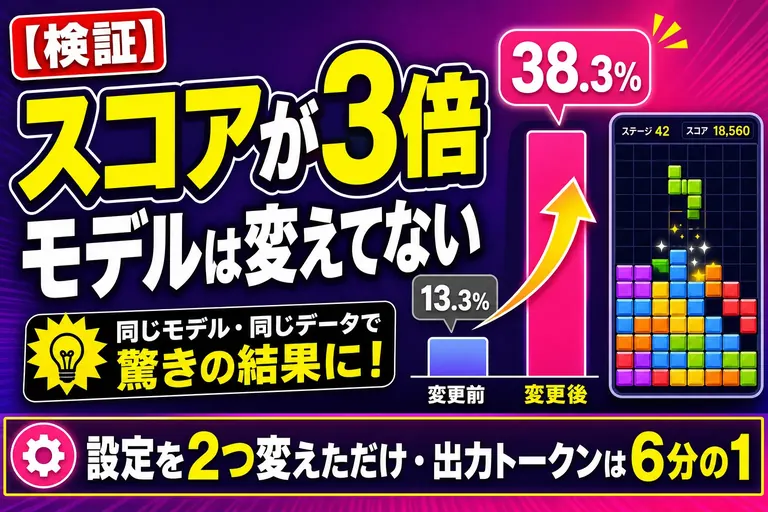
ベンチマークのスコアが3倍・出力トークンは6分の1に——ARC-AGI-3 で効いた「考えを残す」と compaction の2設定
ARC-AGI-3 のスコアはなぜ3倍になった?OpenAI によると変えたのはモデルではなく API の設定2つだよ。GPT-5.6 Sol は公式の土台で13.3%、考えを残して古い履歴を圧縮する設定にしたら38.3%(人間の平均は48%)、出力トークンは6分の1になったんだ。
2026/7/10
OpenAI「GPT-5.6」登場!Solが61%速くて半額、3兄弟モデル
OpenAI が新モデル群「GPT-5.6」を一般公開したよ。最上位 Sol・中位 Terra・下位 Luna の3グレード構成で、Sol は総合指標 Intelligence Index v4.1 で58.9点。Claude Fable 5(59.9点)に1点差まで迫りつつ、所要時間は61%短いんだ。
2026/6/13
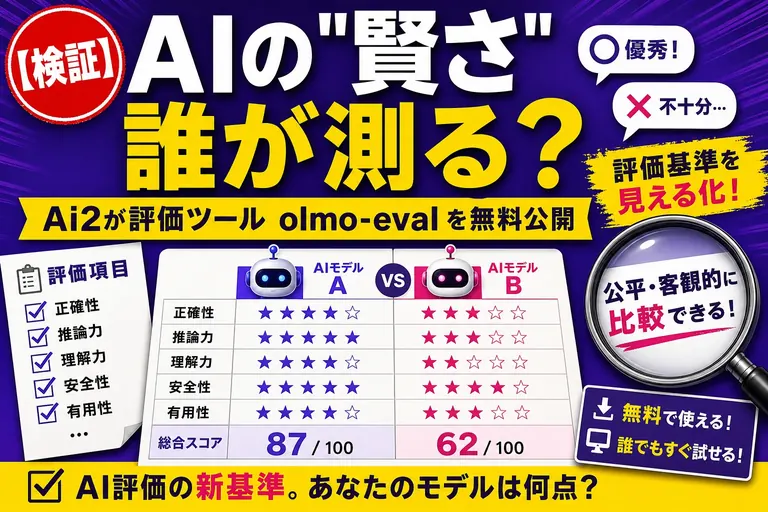
AIの賢さは誰が測ってる?Ai2が『olmo-eval』を公開したよ
AIの賢さは誰がどう測ってる?Allen Institute for AI が公開したオープンソースの評価ツール「olmo-eval」は、開発の途中で何度もテストするための作業台だよ。ツールを使うエージェントや多ターン対話まで評価でき、GitHubで入手できるんだ。
2026/5/14
AIの『長時間タスク能力』、業界予想を吹き飛ばす伸び!MythosとGPT-5.5が『16時間タスク』ラインに突入したよ
AIはどれくらい長い作業をこなせる?米METRと英AISIの評価で、Anthropic の Claude Mythos Preview と OpenAI の GPT-5.5 が50%タイムホライズン16時間超に到達したよ。80%タイムホライズンも4.7か月ごとの倍増ペースを超えたんだ。
2026/5/6
Hugging Face、ASRリーダーボードに『ベンチマクサー忌避剤』を投入。ズル対策が一段階えぐくなったよ
音声認識ベンチマーク Open ASR Leaderboard が、Appen と DataoceanAI の非公開データセット11本(約30時間)を導入。ベンチマーク特化のチューニングを締め出して、本物の精度勝負に持ち込む新方式を解説。