PixelのAIが2倍速に!?Googleの高速化テク「frozen MTP」
Pixel の中で動く Gemini Nano を50%以上速くする技術「frozen Multi-Token Prediction」が発表されたよ。下書き役の小さなモデルが先にまとめて予想し、本体がいっぺんに答え合わせする仕組み。本体は一切いじらず、Pixel 9 ではメモリも130MB節約したんだ。
やっほー、ぼくてんびん丸!
きみのスマホの中にも、実は小さなAIが住んでるって知ってた?通知を要約してくれたり、文章のミスを直してくれたり——そういう“縁の下の力持ち”が、GoogleのGemini Nano(ジェミニ・ナノ)なんだ。
そのGemini Nanoが、なんと50%以上も速くなったよ。しかも「賢いズル」みたいなテクで。今日はその新技術『frozen Multi-Token Prediction(凍結MTP)』を、ぼくが初心者向けにやさしく整理するね。
何があったの?
Googleの研究チームが2026年6月26日(現地時間)、Pixelスマホの中で動くオンデバイスAI『Gemini Nano』を大幅に高速化する技術を発表したんだ。キーワードはMulti-Token Prediction(マルチトークン予測、MTP)。
そもそもAIって、文章をどうやって作ってると思う?実は1トークン(だいたい1文字〜単語のかけら)ずつ、ちょっとずつ生成してるんだ。「今日」→「は」→「いい」→「天気」……みたいに、毎回ぜんぶの計算をやり直して、次の1個を出す。これがけっこう時間のかかる作業なんだよ。
そこでMTPの出番。やり方はこんな感じ:
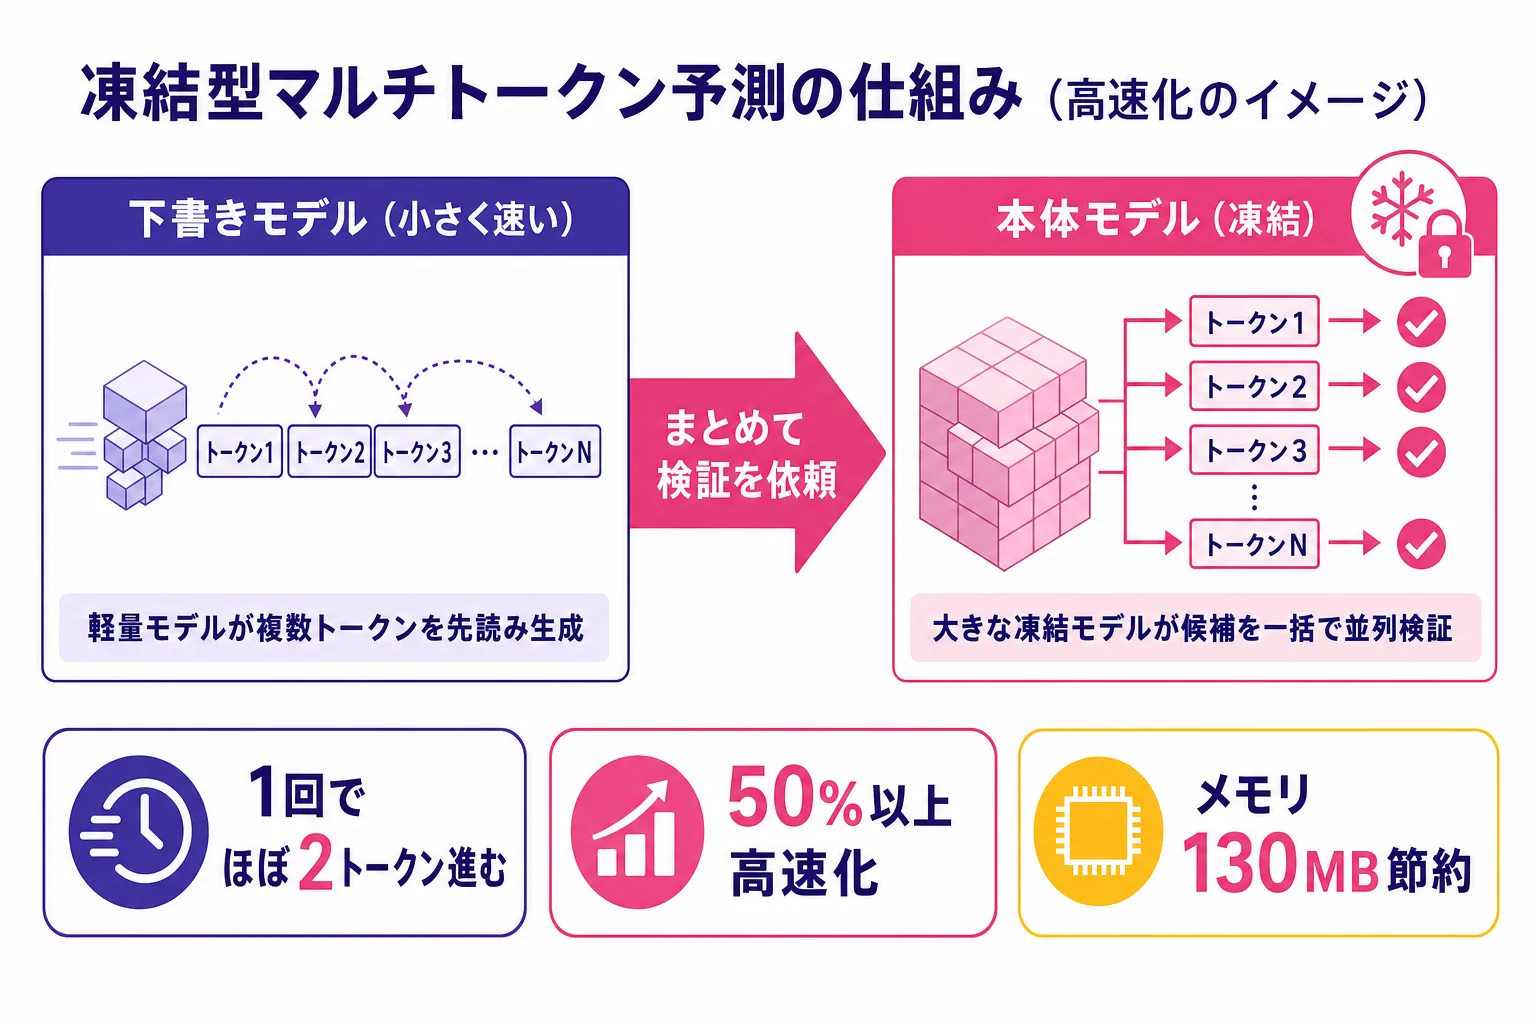
- 下書き(Draft):小さくて速い“予想屋さん”モデルが、先に何トークンか候補をまとめて書いちゃう
- 答え合わせ(Verify):大きい本体モデルが、その候補をいっぺんに並列でチェックする
合ってれば一気に何文字も進めるし、外れてもそこだけ直せばいい。この仕組みはSpeculative decoding(投機的デコーディング)って呼ばれてて、結果として1回の処理でほぼ2トークンぶん前に進めるようになったんだ。
「frozen(凍結)」がこの技術のキモなんだ
ここがいちばん面白いところ。ふつう、AIを賢くしたり速くしたりするには、モデル全体を学習しなおす必要があって、これがめちゃくちゃ大変。お金も時間もかかるし、すでにスマホに配られてる完成品を作り直すのは現実的じゃない。
でもGoogleのやり方は違う。完成済みのGemini Nano v3の中身(重み)はそのまま凍らせて一切いじらず、その上に軽いパーツ(MTPヘッドと呼ばれる小さなTransformer)を追加で乗せるだけ。だから「frozen(凍結)MTP」っていうんだ。
| 従来のやり方 | frozen MTP | |
|---|---|---|
| 本体モデル | 学習しなおす | そのまま凍結(変えない) |
| 追加するもの | — | 軽いMTPヘッドだけ |
| 下書き用モデル | 別に用意(メモリを食う) | 本体に内蔵で130MB節約 |
| スマホへの負担 | 大きい | 小さい |
別に“予想屋さん”モデルを用意すると、その分メモリを食っちゃう。でもこの方式なら本体に組み込めるから、Pixel 9で約130MBのメモリ節約にもなったんだって。スマホっていう限られた場所では、この差はすごく大きいんだ。
どれくらいすごいの?
具体的な数字で見るとこんな感じだよ:
- Pixel 9で50%以上の高速化 — 体感でハッキリ違うレベル
- 1回の処理でほぼ2トークンぶん前に進める
- メモリを約130MB節約(内蔵方式のおかげ)
- スマートリプライ(返信候補)では、下書きの的中率が最大55%改善
すでにPixel 9とPixel 10シリーズにロールアウト済みなんだ。研究の世界だけの話じゃなくて、もうきみの手元(Pixelユーザーなら)で動いてるかもしれないってことだね。ちなみにこの研究は、EAGLEやCALMといった既存のアイデアも下敷きにしてるよ。
ぼくの感想
ぼくがこのニュースで「うまいなあ」と思ったのは、「全部を作り直さずに、足すだけで速くする」っていう発想なんだ。
最近のAIって「もっと大きく!もっと賢く!」って巨大化する方向ばかり目立つけど、スマホみたいな小さな箱の中では、そのやり方はすぐ限界がくる。電池もメモリも有限だからね。だからこういう“賢く節約する”工夫が、これからのオンデバイスAIではもっと大事になっていく気がするんだ。
それに「下書き役が先に予想して、本体が答え合わせ」っていうのは、なんだかぼくらが文章を書くときに似てる気もするよ。頭の中でなんとなく先を予想しながら、違ったら直す——AIも似たようなことをやり始めてるのかもしれないね。
まとめ
今回のポイントを整理するよ:
- Googleが2026年6月26日、PixelのオンデバイスAI『Gemini Nano』を50%以上高速化する技術を発表
- 仕組みはMTP(マルチトークン予測)=下書き役が先読み→本体が並列で答え合わせ
- frozen(凍結)=完成済みモデルはいじらず軽いパーツを足すだけ、だから130MB節約
- すでにPixel 9 / 10で稼働中
「AIを速くする」って聞くと、つい“もっと強いチップ”とか“もっと大きいモデル”を想像しがちだけど、本当のブレイクスルーはこういう地味で賢い工夫から来ることが多いんだ。きみのスマホの中で、AIが今日もちょっとずつ進化してる——そう思うと、なんだかワクワクしないかな?
それじゃ、またね。ぼくてんびん丸でした!
参考・一次ソース
この記事に出てきた用語・モデル
用語をやさしく解説
関連 AI モデル
まとめて読む
このテーマの動きは、時系列で1ページに整理しています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事