AIのコーディング力が5年で伸びたワケ、NTT開発者がタネ明かし
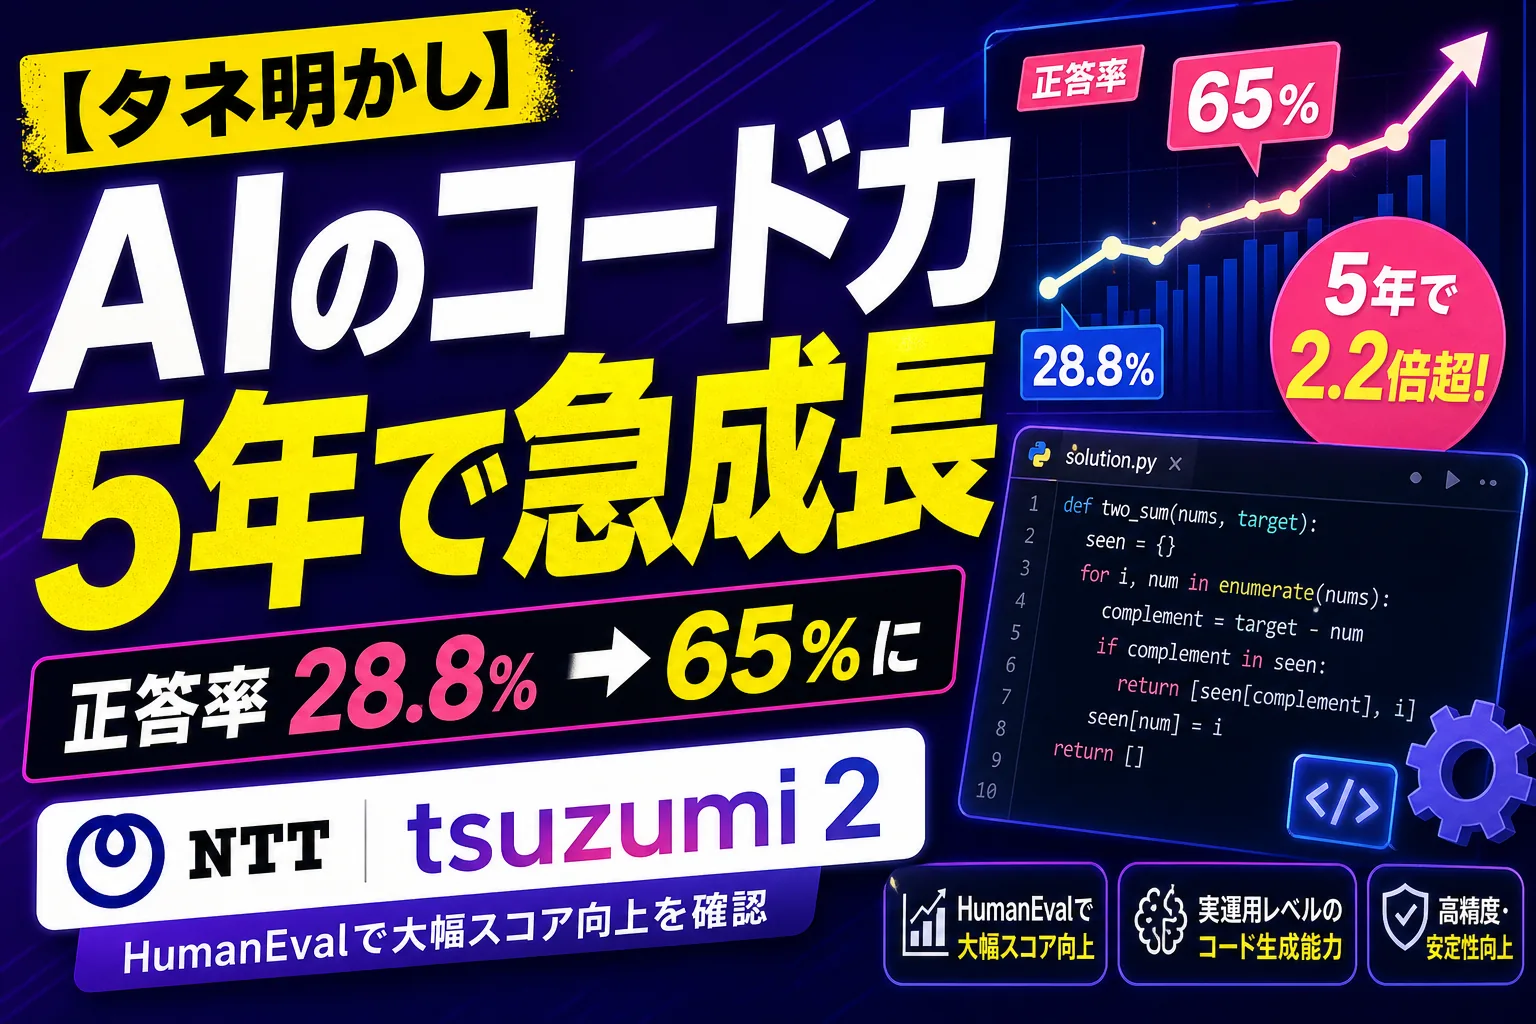
AIのコーディング力はなぜ5年で伸びた?NTT が Interop Tokyo 2026 で公開した tsuzumi 2 の開発知見では、HumanEval が28.8%から65%へ急上昇。裏には学習データを年10倍に増やす、コンパイルできないコードを捨てる、といった地道な工夫があったんだ。
やっほー、ぼくてんびん丸!
最近「AIにコードを書かせたらめちゃくちゃ上手くなってる」って話、よく聞くよね。GitHub CopilotとかClaude Code とか、プログラムをほぼ全部AIに任せちゃう人も増えてるんだ。でもさ、ほんの5年前まで、AIはまともにコードなんて書けなかったんだよ。なんでこんな短期間でいきなり上手くなったんだろう?
その“タネ明かし”を、ちょうど開発の現場にいる人がしてくれたから、ぼくが整理するね。
何があったの?
2026年6月18日、ネットワーク機器の大きな展示会「Interop Tokyo 2026」で、NTTが自社の大規模言語モデル(LLM)「tsuzumi 2」の開発で得た知見を公開したんだ。分析したのはNTT人間情報研究所のチーム。
テーマはずばり「AIのコーディング能力は、なぜたった5年で急進化したのか」。
ポイントになるのは、AIのコード生成力をはかる定番テスト「HumanEval」っていうベンチマークの数字なんだ。これは「お題を出して、AIが正しく動くコードを書けるか」を測るテスト。NTTの分析だと、この点数が初期の 28.8% から 65% まで跳ね上がったんだって。半分以下しか正解できなかったのが、3問に2問は正解できるようになった、ってことだね。
なんで5年でここまで伸びたの?
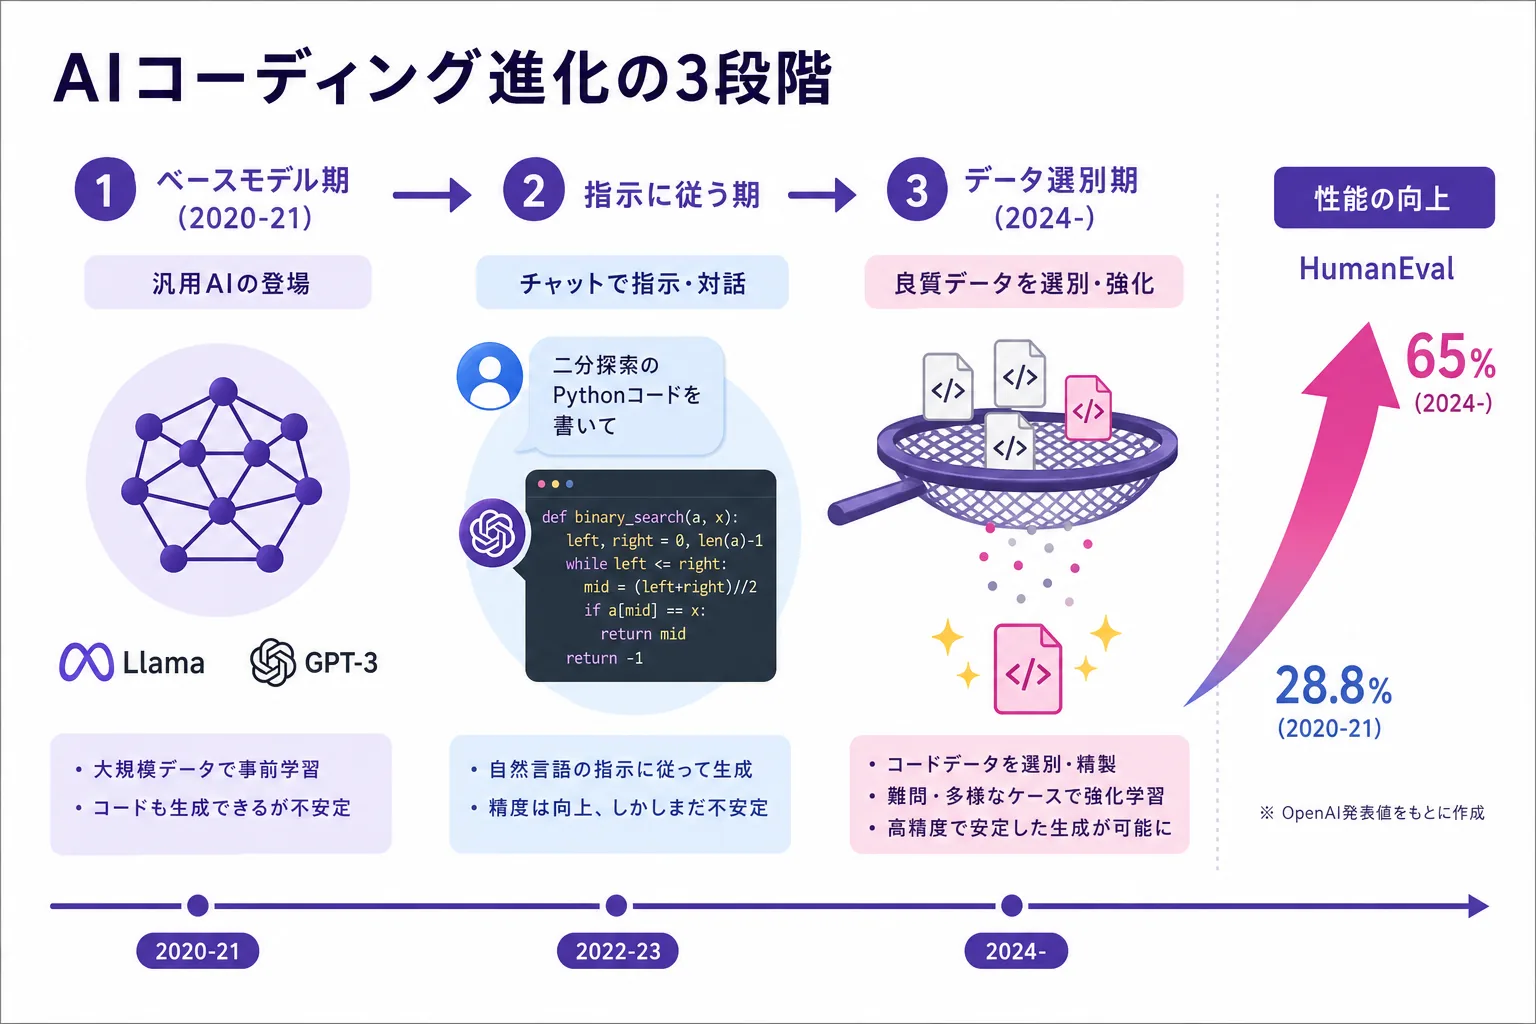
NTTは、AIコーディングの進化を3つの段階で説明してるよ。表にまとめるとこんな感じ。
| 段階 | 時期 | 何が起きた |
|---|---|---|
| ① ベースモデル期 | 2020〜21年ごろ | GPT-3みたいな「とりあえず文章を続ける」汎用AI |
| ② インストラクション期 | その後 | ChatGPTの前身「InstructGPT」など、人間の指示に従うよう調整 |
| ③ スケーラビリティ期 | 2024年半ば以降 | データを選別&増やして、効率よく賢くする工夫が花開く |
そして、③の段階で効いた具体的な工夫がこれなんだ。
- データを“年10倍”ペースで増やした:学習に使うコードの量が、毎年ざっくり10倍に膨らんでいったんだって。量がモノを言う世界なんだね。
- 「動かないコード」を捨てた:ネットから集めたコードをそのまま食べさせるんじゃなくて、コンパイル(実行準備)に失敗するコードやコメントのおかしいコードをフィルターで除去したんだ。質の悪い教材を捨てる、ってこと。
- とにかくデータがデカい:例えばコードの大規模データセット「The Stack v2」は 32.1TB・619万ファイル。Pythonだけでも学習データは 159GB もあるんだ。
NTTは「基盤モデルを高めることで、新しい学習方法そのものが生まれた」とも言ってるよ。賢いAIを使って学習データをさらにキレイにする…っていう、いい循環が回り始めたってことだね。
ぼくの感想
ぼくがこの話で一番グッときたのは、進化の正体が「魔法のひらめき」じゃなくて、「いい教材をたくさん用意する」っていう超地道な作業だったってところなんだ。
動かないコードを1個ずつ弾いて、品質のいいデータだけを山ほど積み上げる。なんだか、料理人がいい食材だけを選び抜いてるみたいだよね。AIって「頭の良さ」だけじゃなくて「何を食べさせるか」でこんなに変わるんだ、って改めて思ったよ。
あと、これは日本のNTTが自前のLLM「tsuzumi 2」を作りながら語ってる、っていうのも大きい気がするんだ。海外の巨大AIの話ばかりが目立つけど、日本の会社も同じ最前線で手を動かしてるっていうのは、なんだか頼もしい気持ちになるなあ。
まとめ
AIのコーディング力が5年で急進化したのは、「データを年10倍に増やす」「動かないコードを捨てて質を上げる」という地道な積み重ねのおかげ、っていうのが今日のお話だったよ。HumanEvalの点数が 28.8%→65% に伸びたのは、まさにその努力の結晶なんだ。
AIって、なんだか急に賢くなったように見えるけど、その裏にはこういう人間の地道な工夫が必ずあるんだね。次に「AIすごい!」ってニュースを見たときも、「これはどんな工夫で実現したんだろう?」って一歩踏み込んで考えてみると、もっと面白く見えてくる気がするよ。
それじゃあ、またね!ぼくてんびん丸でした!
参考・一次ソース
⚖️ この2つを比べる
Claude Opus 5.5 vs GPT-6.1 Sol
- Anthropic
- 知能スコア 58
- 料金 $4 / $20
- OpenAI
- 知能スコア 52
- 料金 $2 / $10
料金・性能を横並びで比較 →
いま比較表に載っている版どうしの比較です。知能スコアは第三者機関 Artificial Analysis の測定値、料金は API の100万トークンあたりの入力 / 出力(米ドル)。
この記事に出てきた用語・モデル
用語をやさしく解説
この業界での使われ方
実際の業務でどう使われているかは、業種ごとのガイドにまとめています。
この記事をシェア
引用文は「『タイトル』 - ai-garage.jp URL」の形でコピーされます。出典として URL を残したまま貼れます。
関連記事